整理我与 AI 的一些对话和思考,记录关于大模型、技术变化与智能时代的持续观察。技术部分是理解的基础,文末用日常语言做整体理解,是这篇的落点。
目标读者:对 AI 好奇,想知道「它是什么,是怎么想的」。
这篇文章讲什么
大模型(LLM,Large Language Model) 是指像 ChatGPT、Claude、Gemini、DeepSeek、Kimi、豆包这类能理解和生成自然语言的 AI 系统。「大」指的是模型参数量巨大(通常数百亿个),「语言模型」指的是它的核心能力是理解和生成语言。
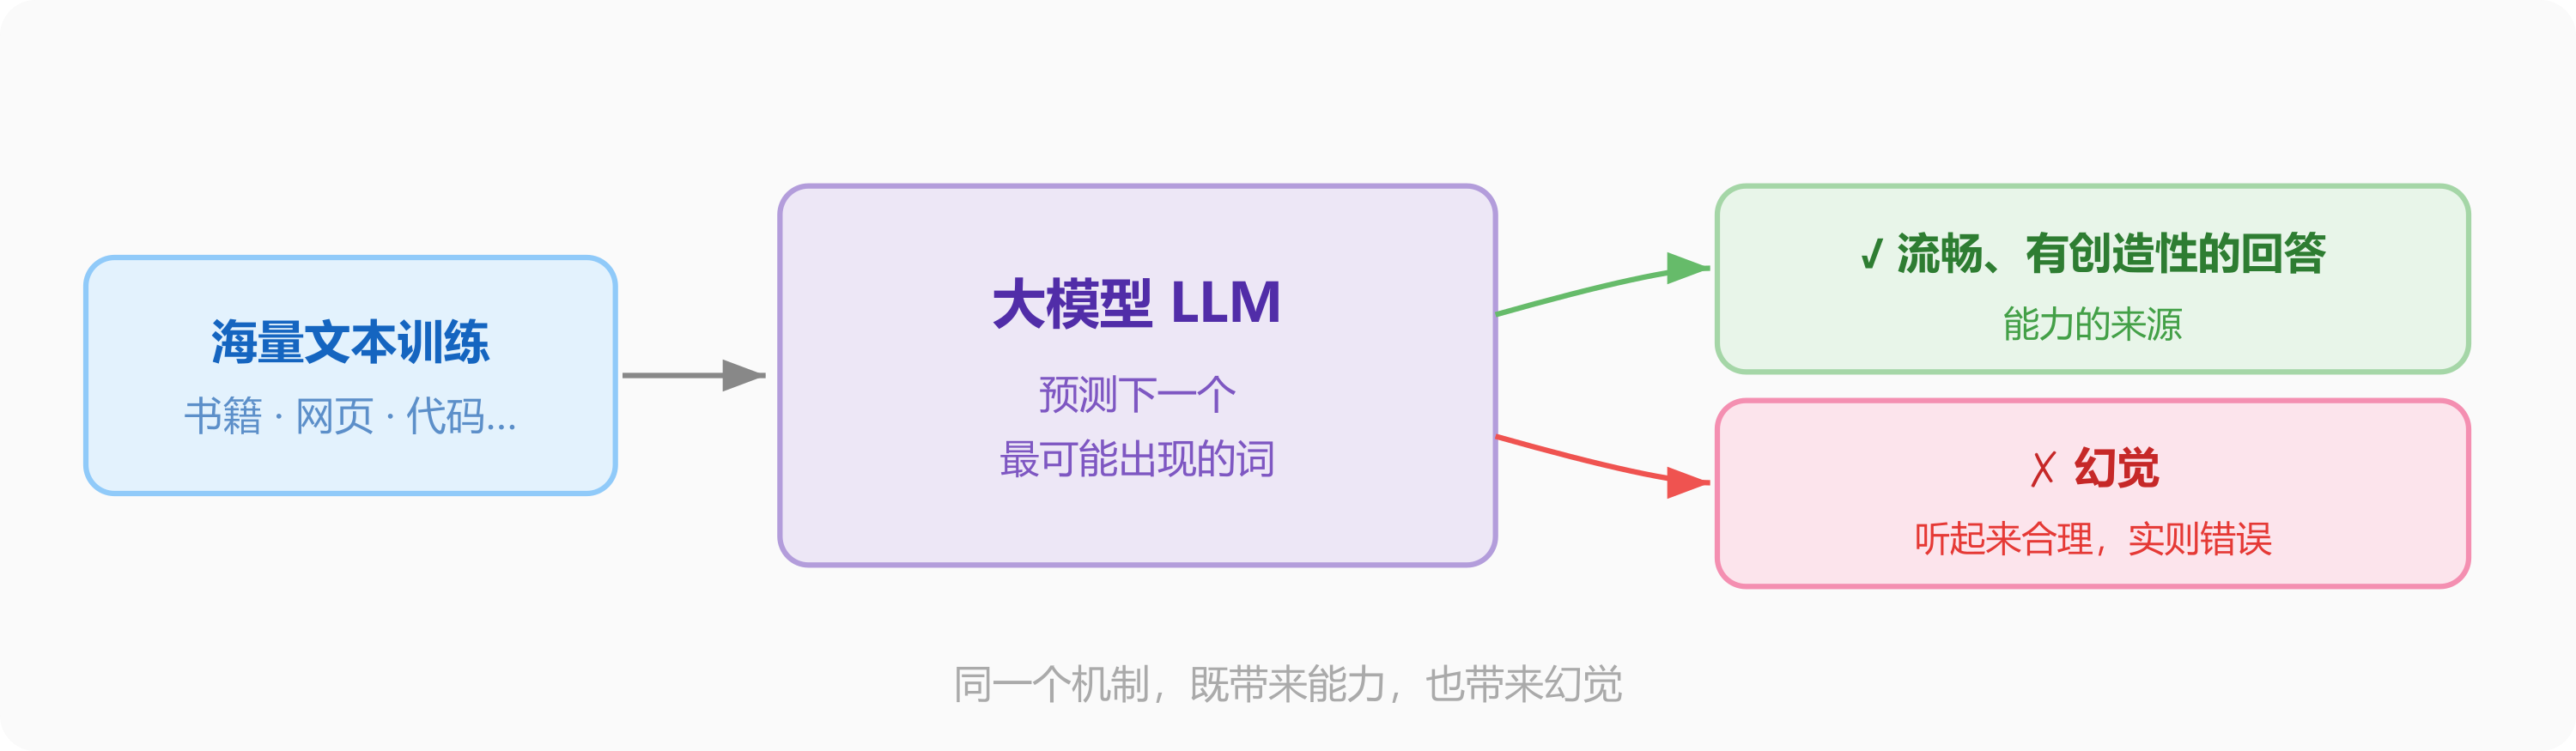
大模型不是在查数据库,也不是在执行人写好的规则——它是通过海量文本训练出来的「概率预测系统」,本质上在做一件事:预测下一个最可能出现的词。
这个机制带来了惊人的能力,也带来了一个著名的缺陷:幻觉(Hallucination)——模型会生成听起来很合理但实际上是错误的内容。理解幻觉的根源,是用好 AI 工具的基本功。
今天说的「AI」,大多数时候指的就是大模型。下文从神经元讲起,经涌现与训练,落到幻觉——帮你建立对大模型工作方式的完整认知。
模型是用代码搭建的吗?它是把人类思维程序化了吗?
是。用代码搭建的,但内部的逻辑不是人写的,是学出来的。
代码定义了神经网络的结构(哪些「神经元」怎么连接),但权重(连接的强度)是通过训练自动调整的。没有人写「遇到这个问题用这个推理方法」,模型的「推理能力」是从海量数据里涌现出来的。
神经网络最原始的东西是什么?
一个神经元:收多个输入(x1、x2、x3) → 每个乘以权重(w1、w2、w3) → 加在一起 → 经激活函数处理后输出。
输入 x1, x2, x3
加权求和:x1×w1 + x2×w2 + x3×w3 + b
激活函数:max(0, 结果)    ← 引入非线性
输出一个数
可以画成这样:
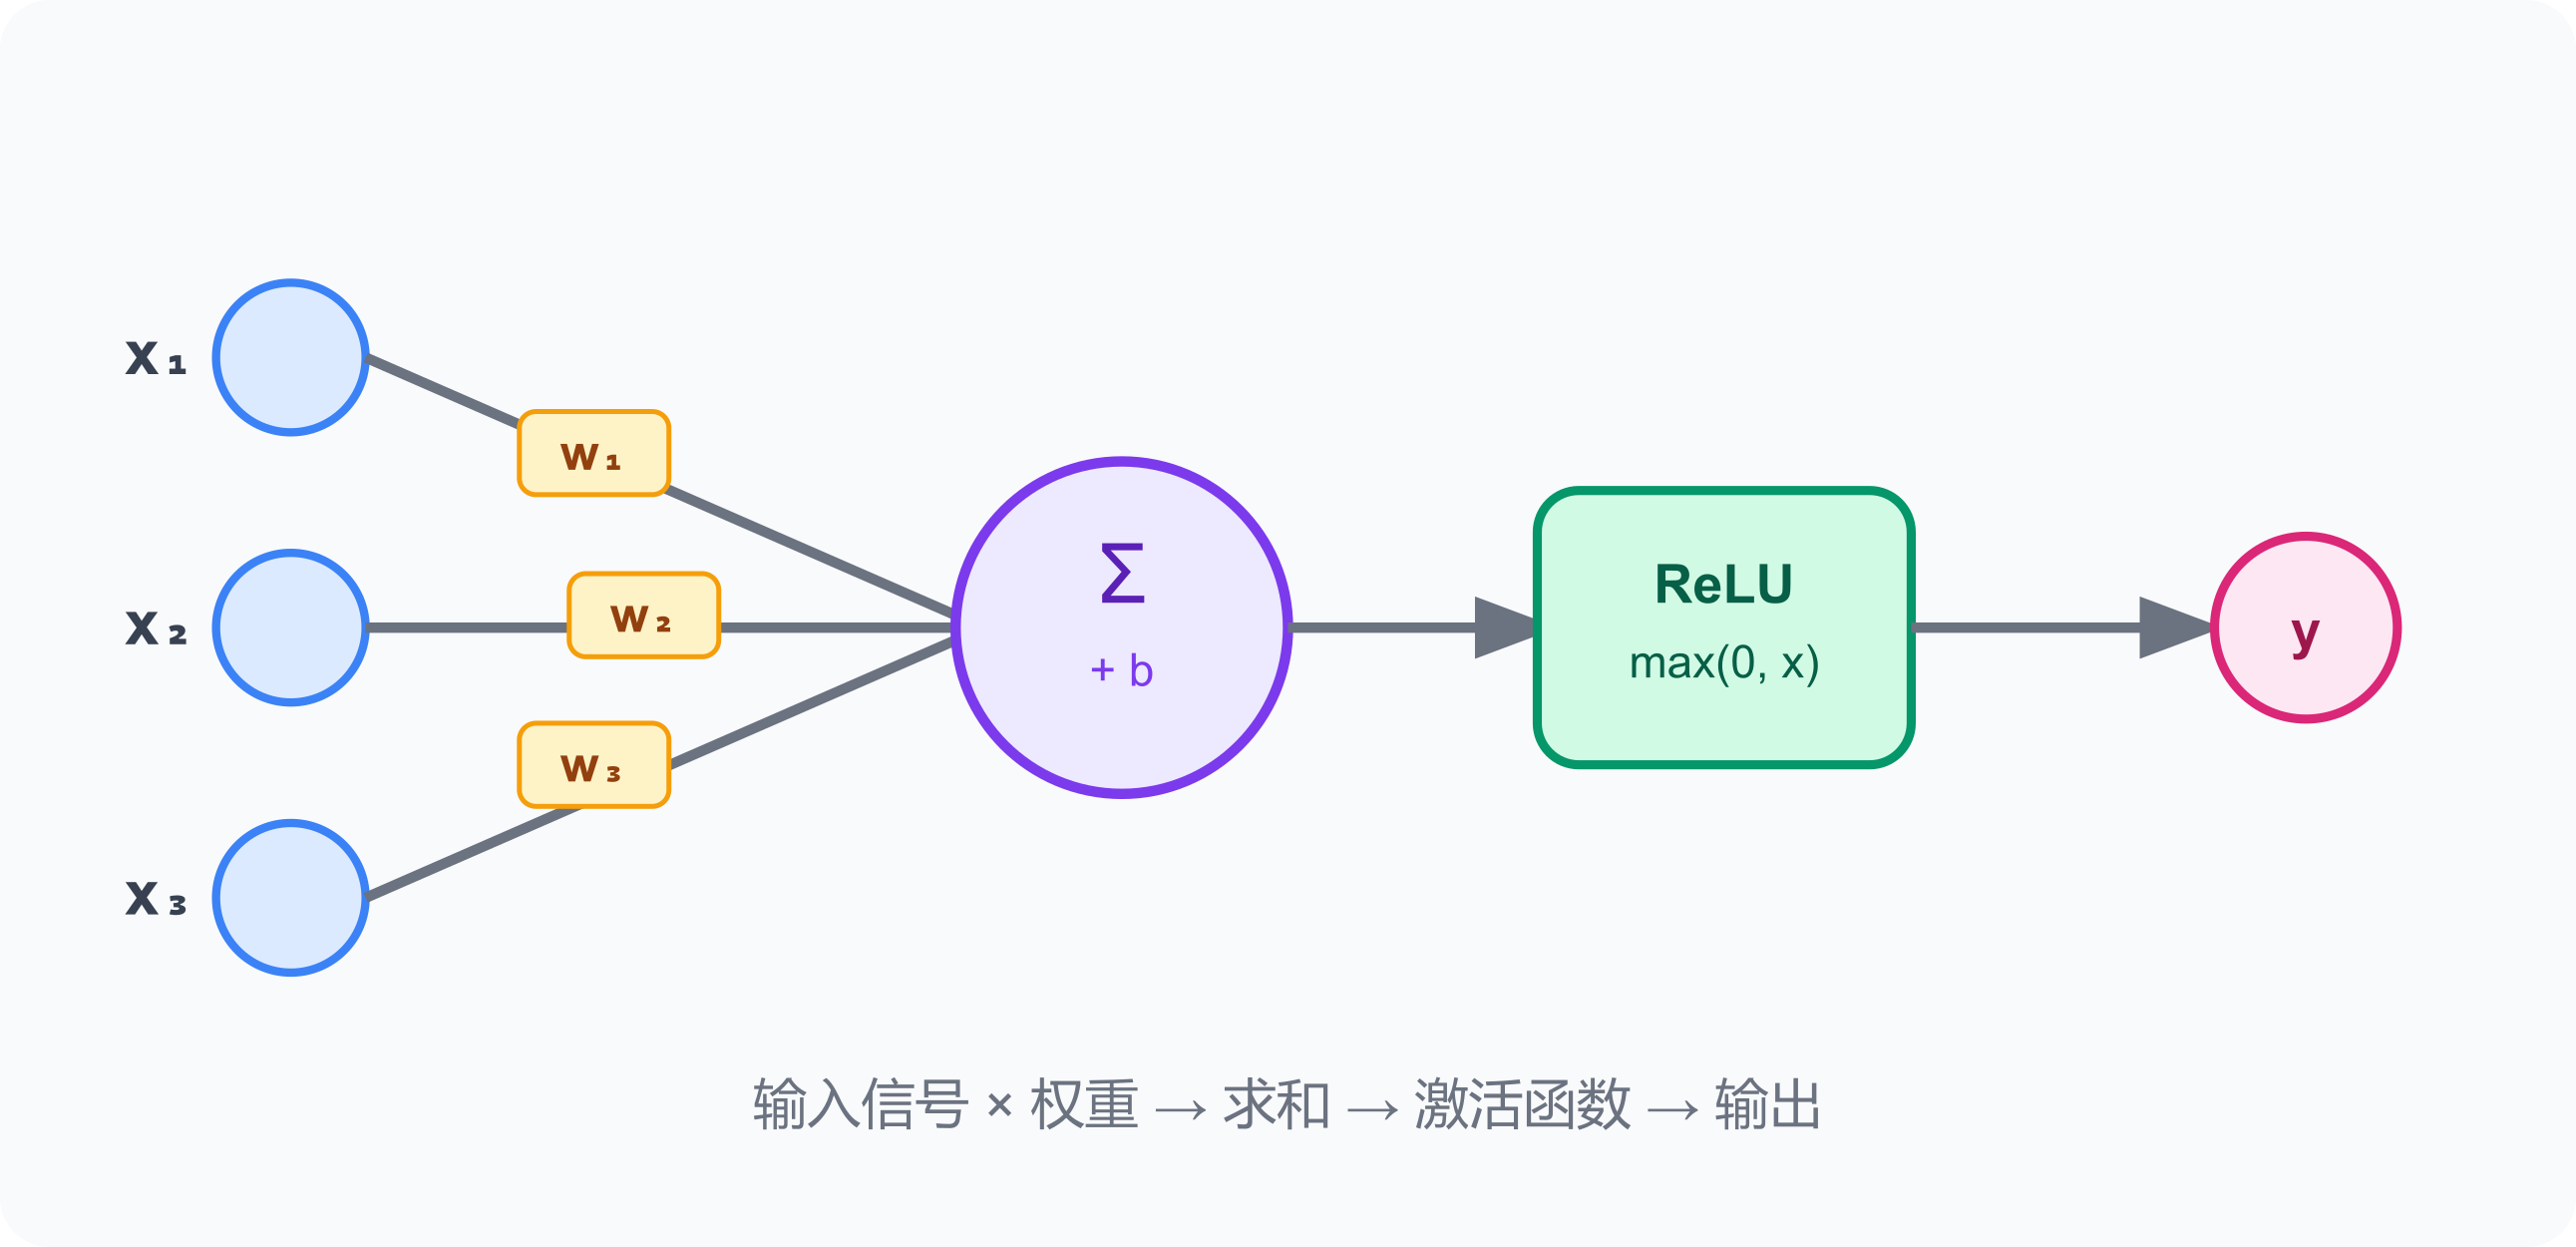
成千上亿个这样的单元叠在一起 = 神经网络。结构(层数、连接方式)是人设计的,权重值是学出来的。
神经网络的「层」是什么概念?
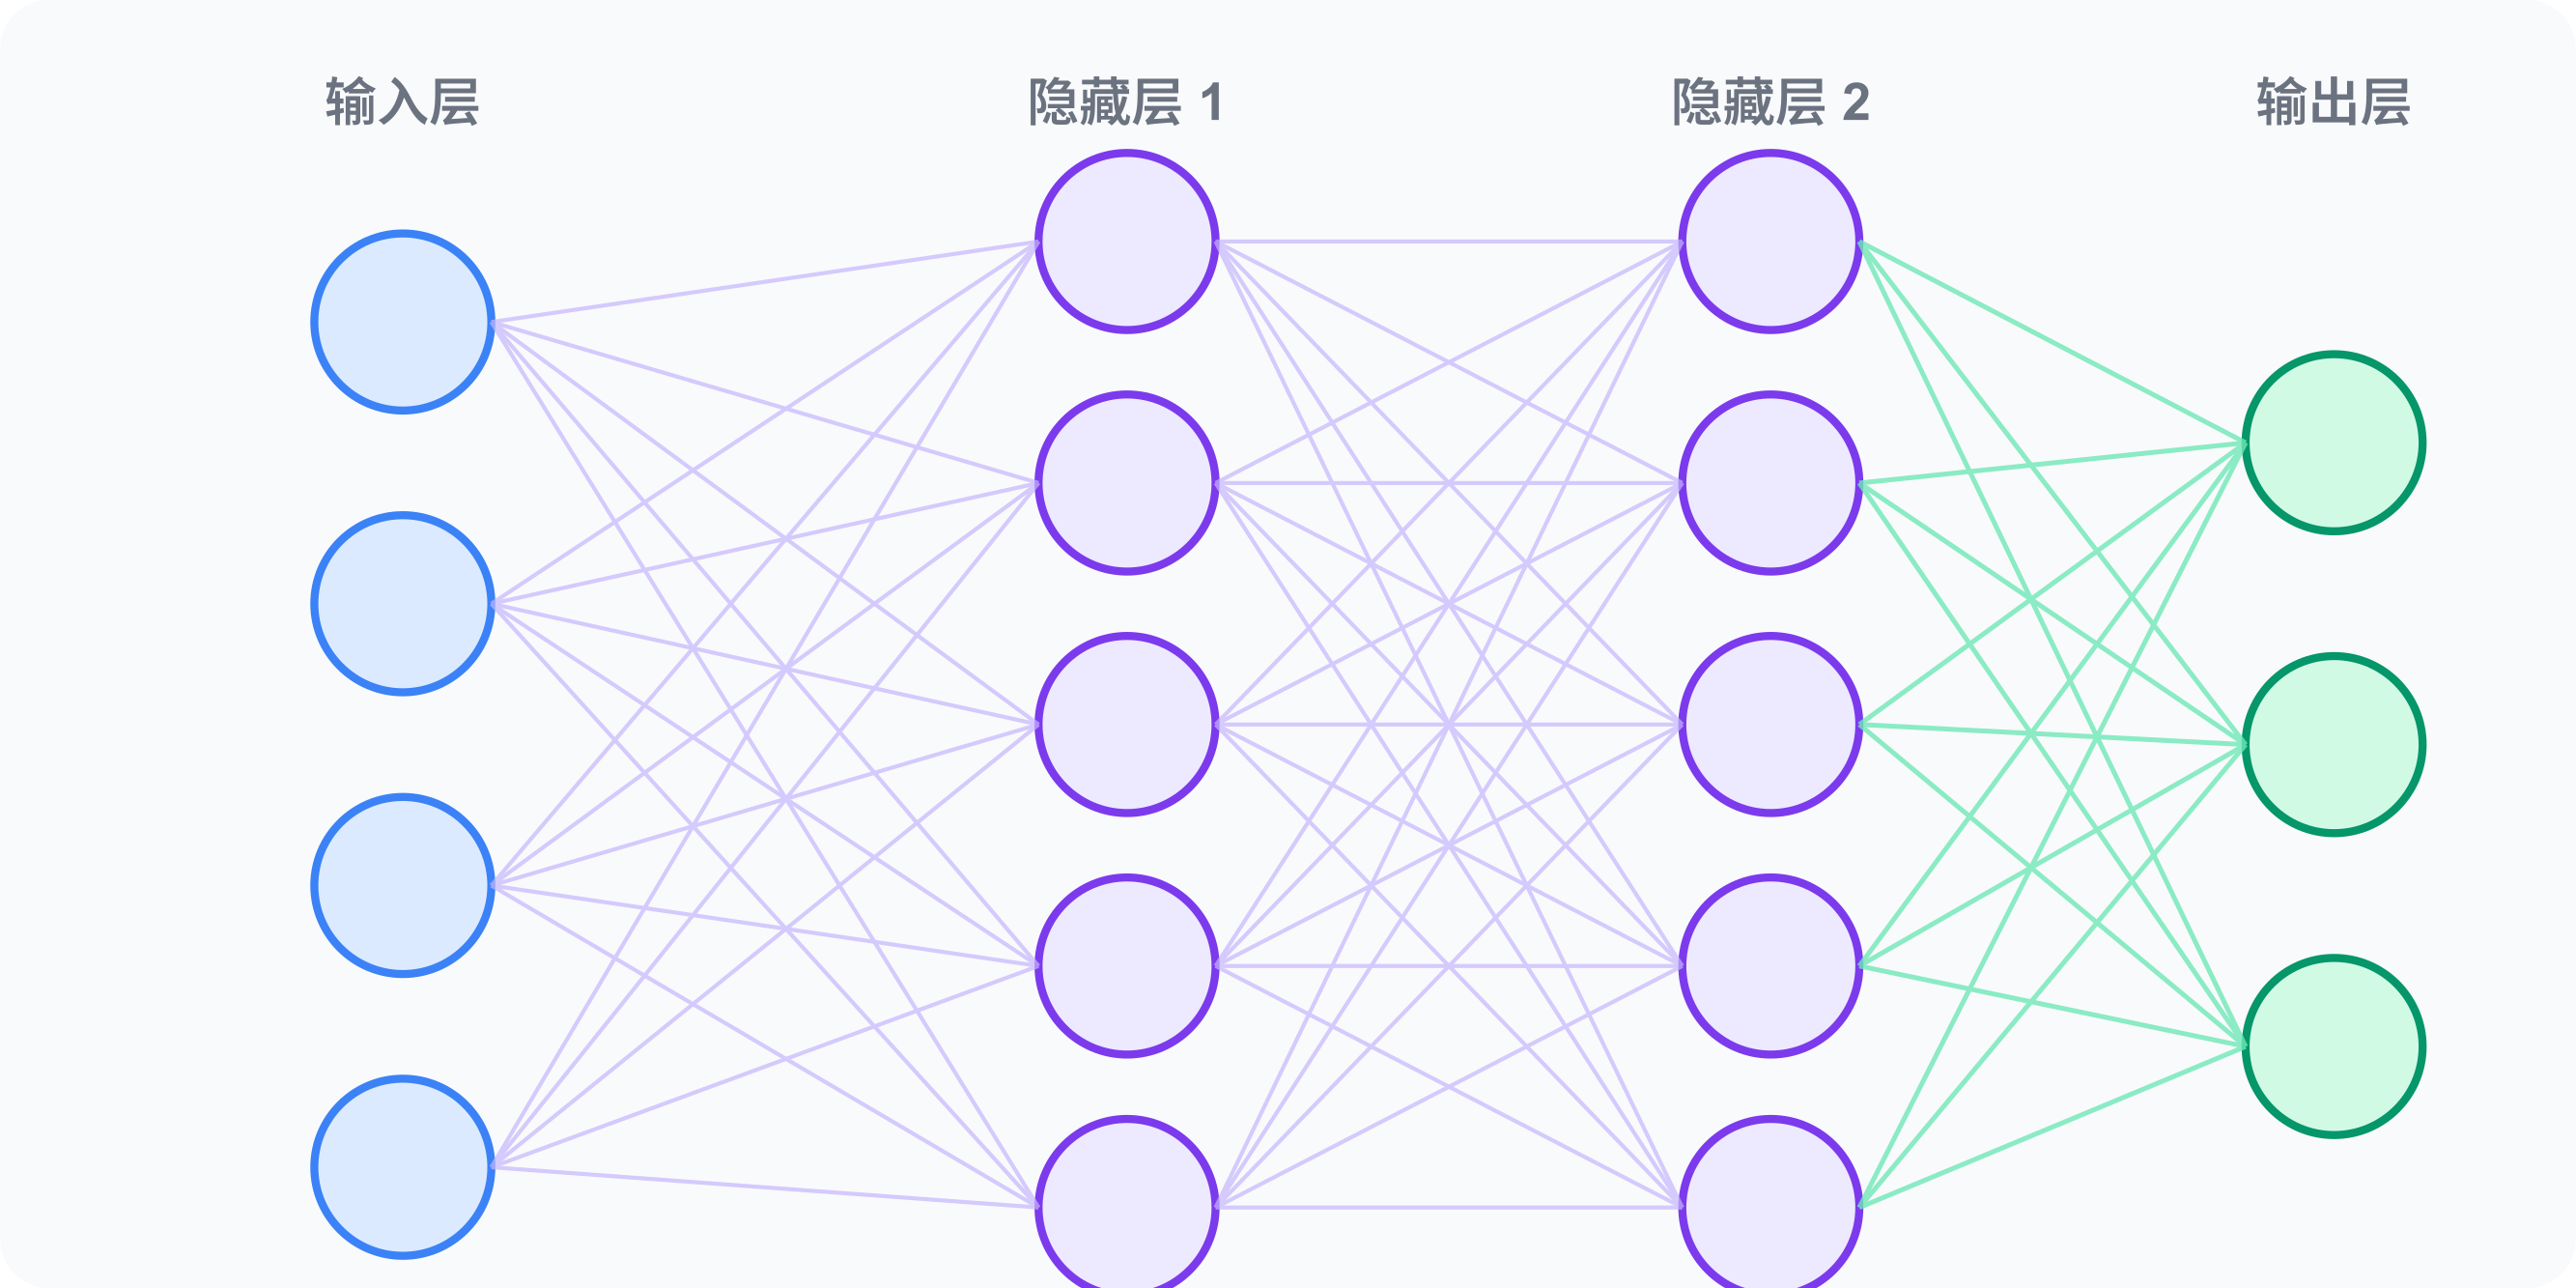
「深度」学习的「深」,就是指层数多——现代大模型有几十到上百层。
生物神经元也有权重:突触强度 = 反复激活的连接变强,不用的变弱(Hebb 规则,1949年神经科学家 Donald Hebb 发现)。人工神经网络用数字精确模拟了这个机制。
权重是不是就像肌肉记忆?或者「一人通过的小桥」和「十车道大路」?
对,这个比喻非常准确。
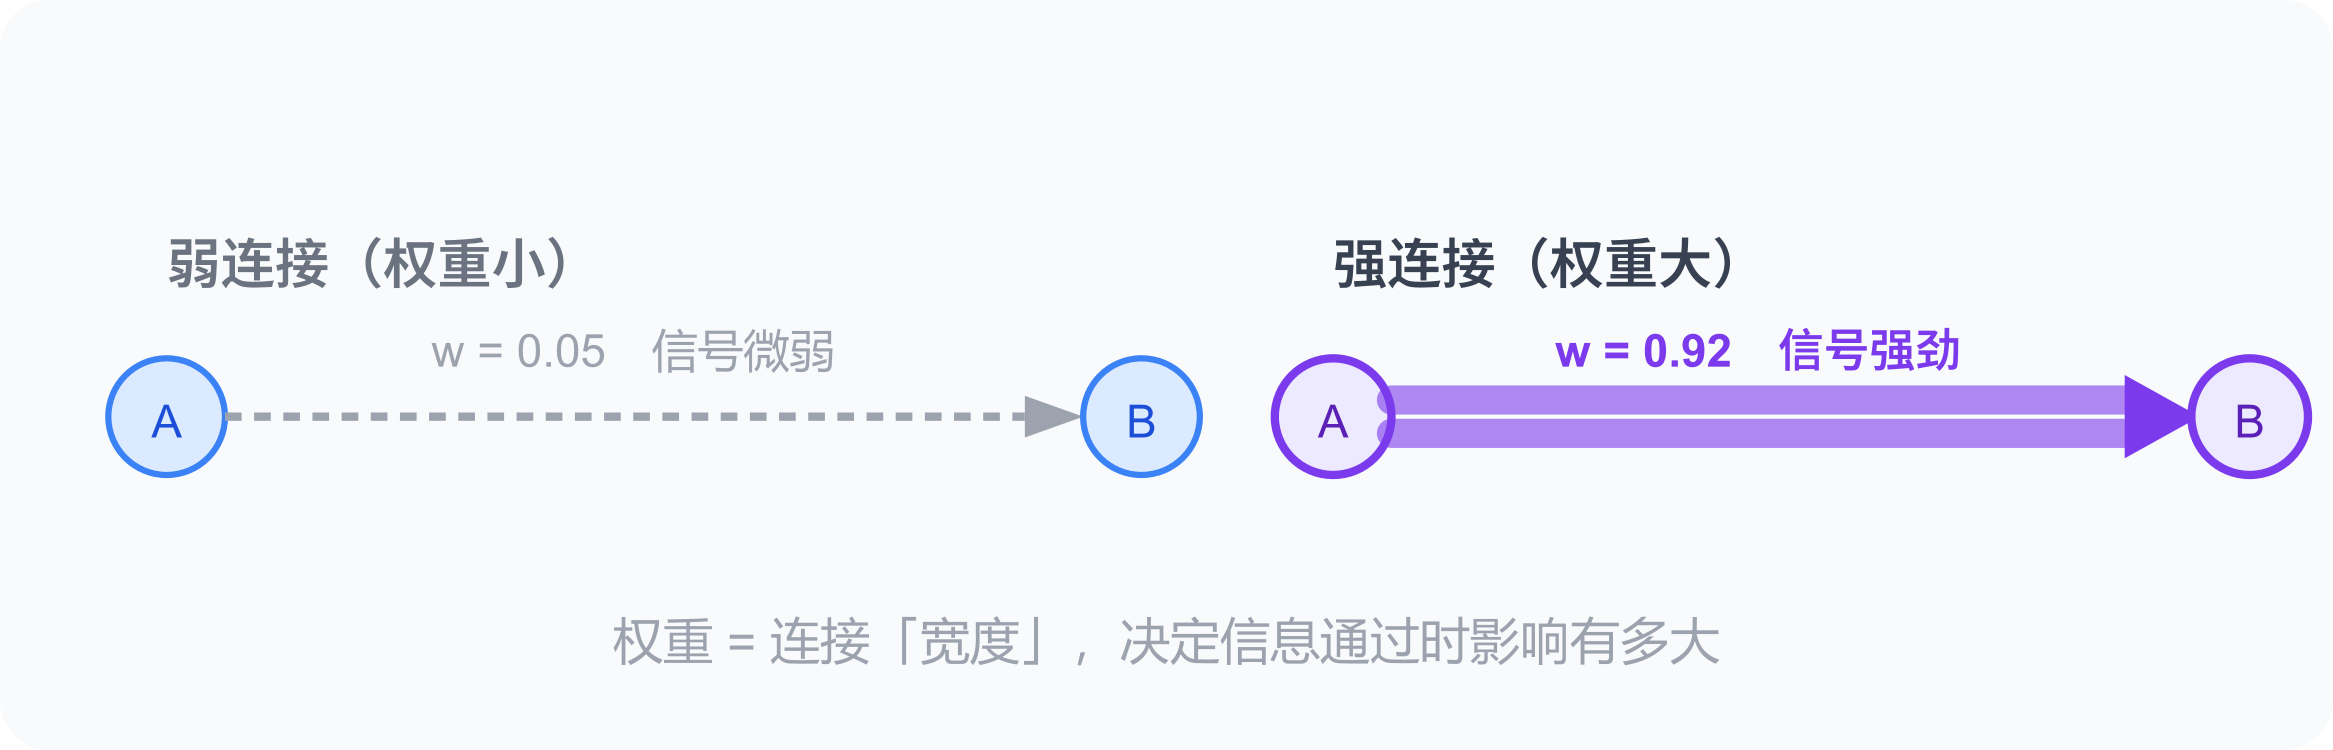
反复用某条路径 → 路变宽 → 通行更快更稳定。权重越大的连接,信息通过越顺畅,对结果影响越大。
肌肉记忆的神经机制也是这个:弹钢琴时反复练习的指法,对应的神经连接权重增加,不需要有意识控制就能流畅执行。
人工神经网络的训练权重,就是这个机制的数字版。
激活函数为什么要引入「非线性」?
线性叠多少层还是线性,解不了复杂问题。
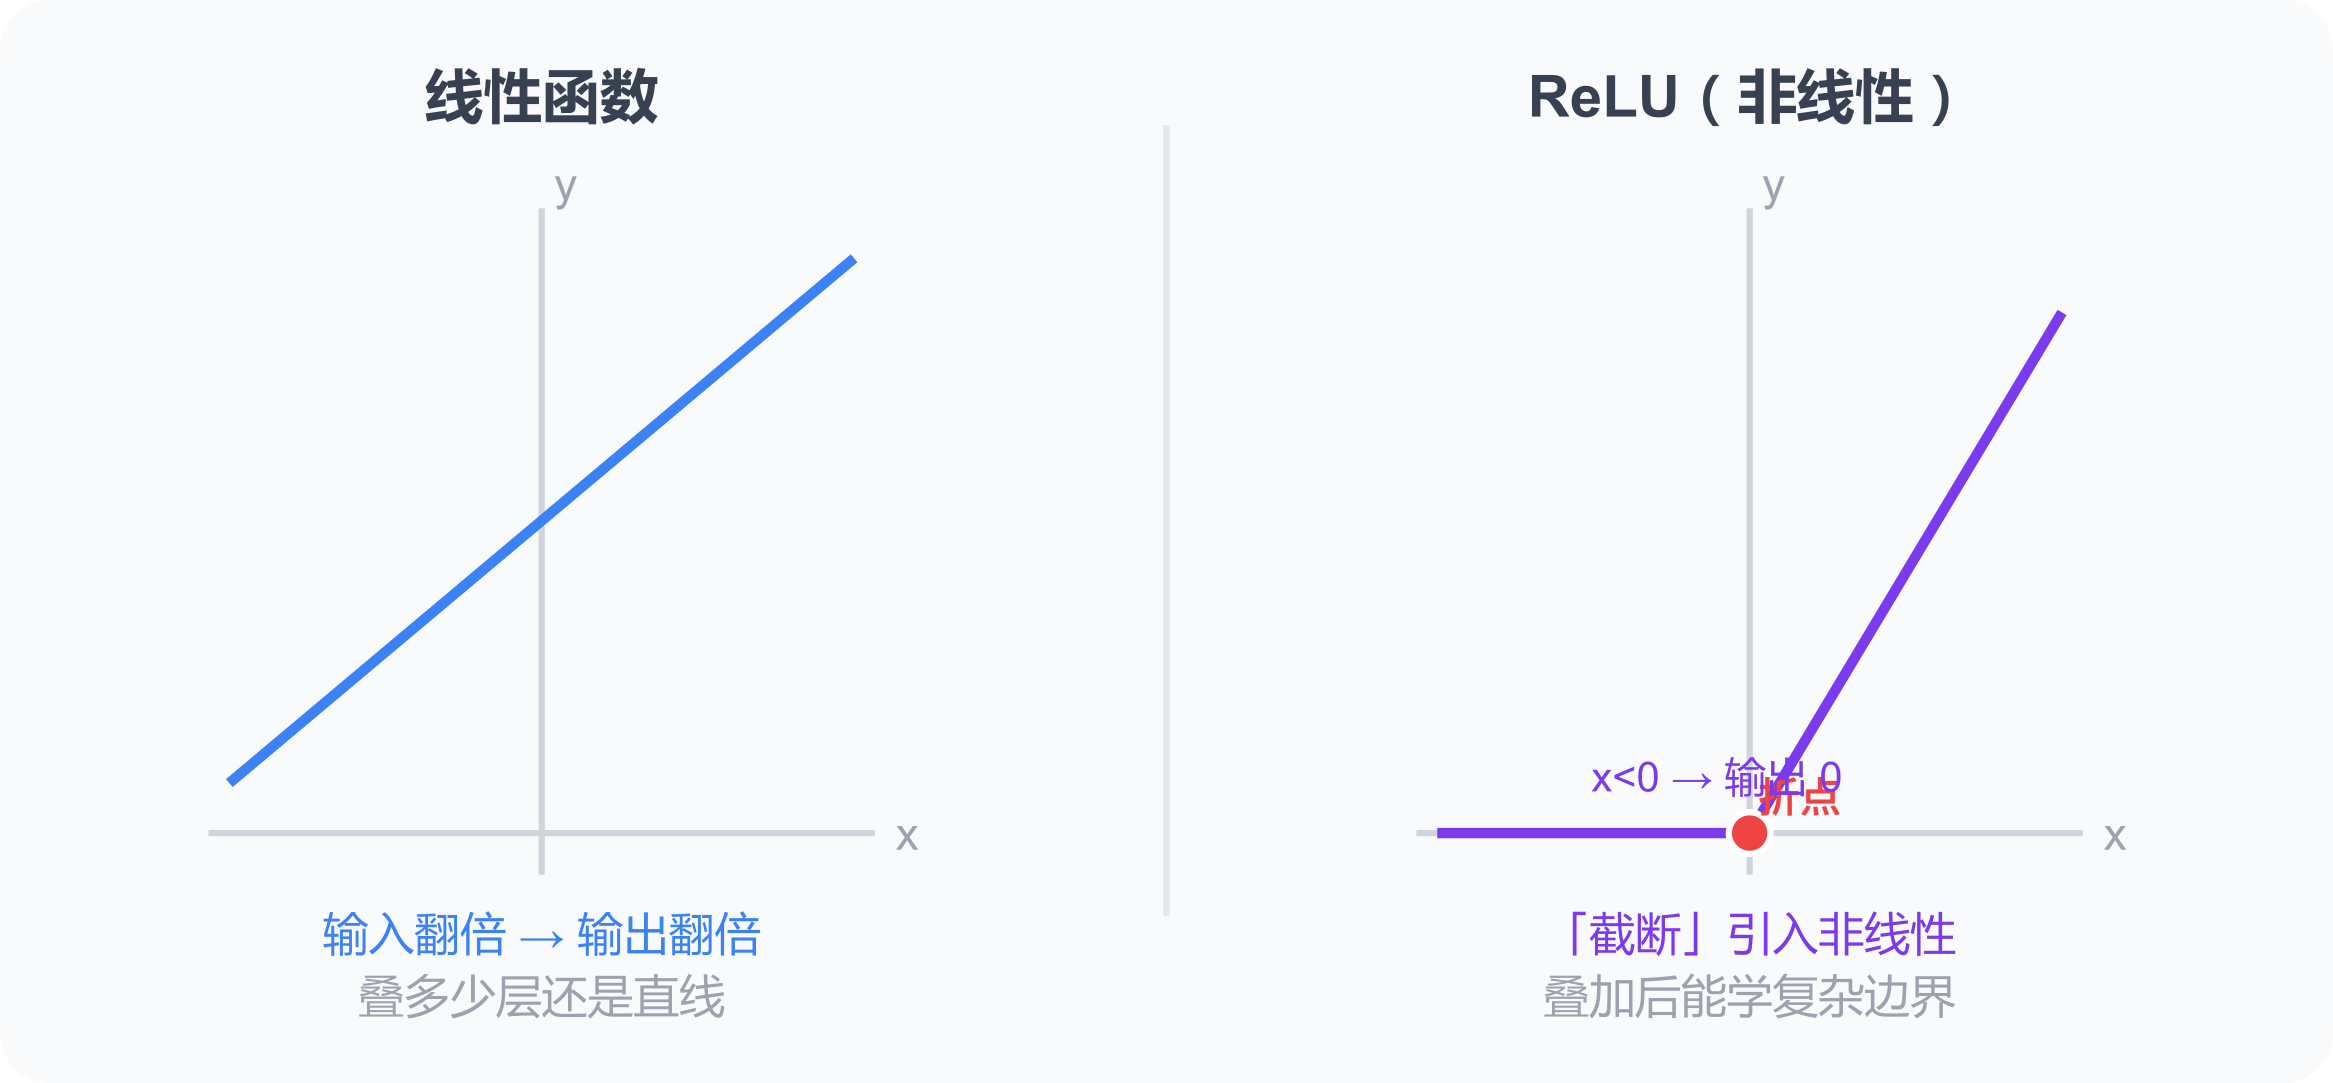
线性:输入翻倍 → 输出翻倍,可预测,只能表达直线关系。
激活函数(如 ReLU):输入小于 0 → 输出 0(截断);大于 0 → 正常输出。这个「截断」就是非线性。
多层叠加非线性 → 模型能学会「这个条件满足才激活,否则静默」——也就是分类、边界识别、复杂模式。
「突破到某个层级后,回报成倍增长」——这也是非线性的一种体现:AI 能力随规模增大出现「涌现」现象,某个阈值后能力突然跳升,不是线性增长。
小结:神经网络
大模型不是人工写规则的系统——它的「智能」来自结构加数据,逻辑是训练出来的,不是编程进去的。这里建立的是最底层的认知:
- 神经元 = 加权求和 + 激活函数:权重决定连接强度,激活函数引入非线性,让模型能学复杂模式
- 权重是训练出来的:代码定义结构,权重值通过梯度下降自动调整,没有人手写规则
- 非线性的意义:线性叠多少层还是线性;非线性让「涌现」成为可能——能力随规模超线性增长
- 内部的逻辑是学出来的:模型的「推理能力」是从海量数据里涌现出来的
什么是涌现?
涌现(Emergence)= 小模型完全不会、大模型突然就会了的能力。
不是「随着规模增大慢慢变好」,而是在某个规模阈值前后,能力像开关一样跳变——之前表现接近随机,之后突然大幅跃升。
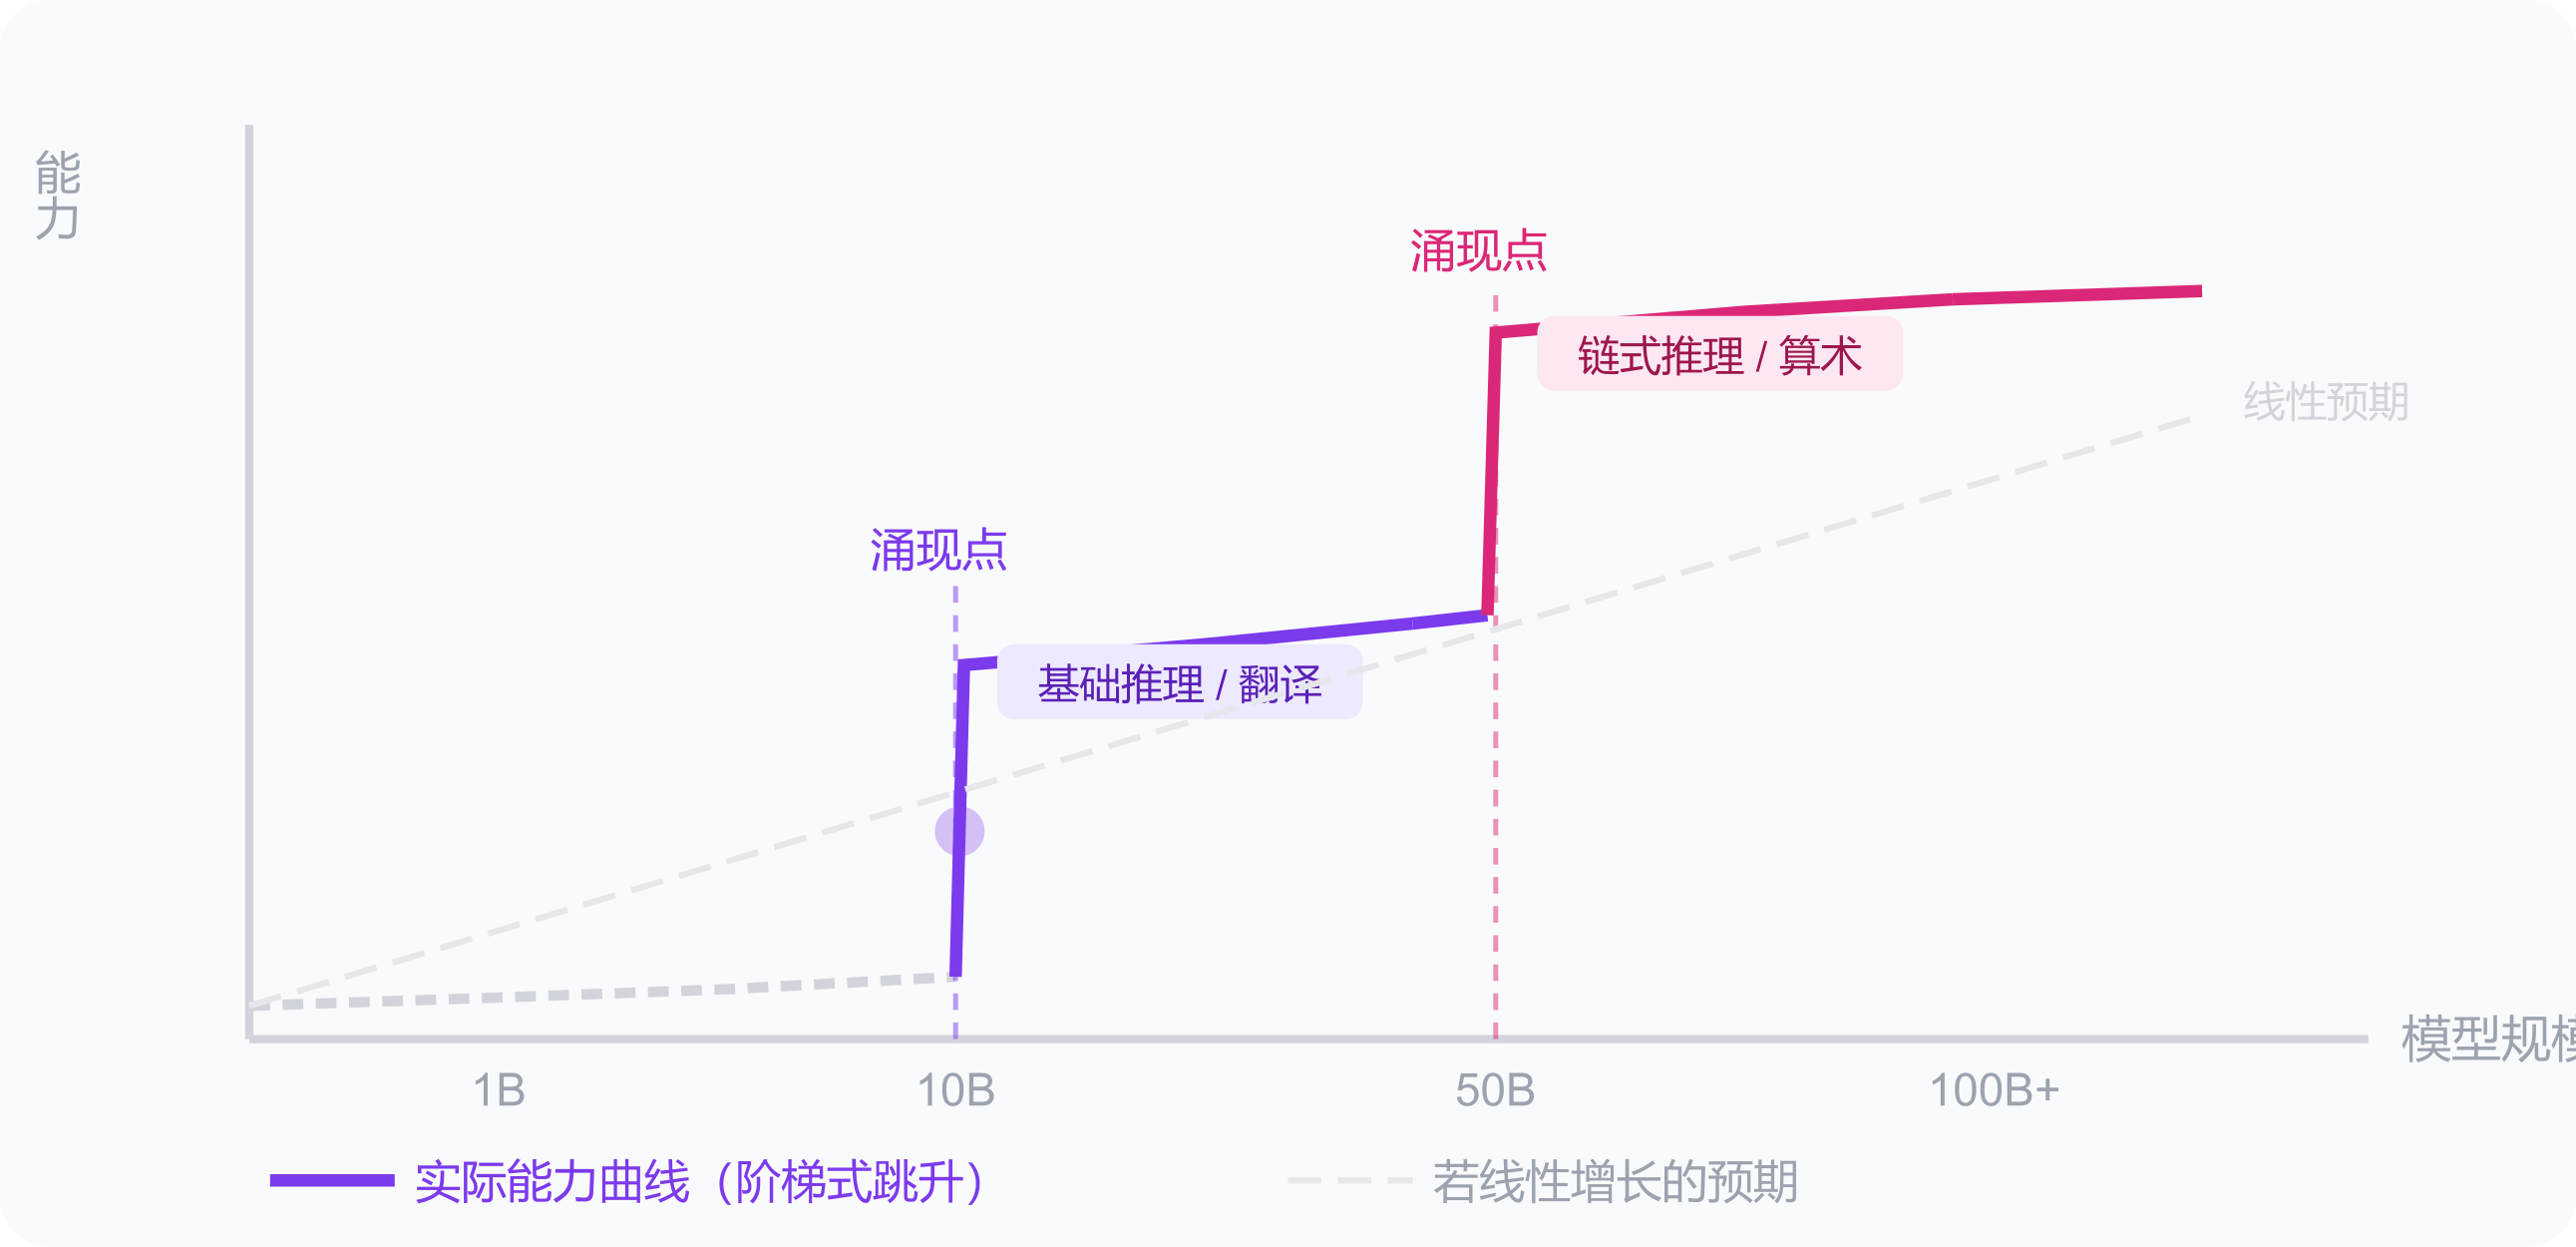
为什么不是线性增长?
模型参数翻倍,并不意味着能力翻倍。前期增加的参数在「打基础」——学词法、语法、常见搭配——这些积累在表面上看不出能力差异。当某个任务所需的所有子能力都达到临界点,能力才集中爆发出来。
类比:水降温到 0°C 之前,液态性质几乎没变化;跨过 0°C 瞬间结冰——相变就是涌现。
具体例子:
| 能力 | 小模型(≤10B) | 大模型(≥50B) |
|---|---|---|
| 基础翻译 | 勉强可用 | 流畅自然 |
| 数学应用题逐步推理 | 几乎不会 | 突然会了 |
| 少样本学习(看几个例子就推广) | 随机水平 | 明显有效 |
| 代码调试、解释错误 | 混乱 | 基本可靠 |
涌现让预测变难:你没办法只看小模型的表现来推断大模型会不会某个能力。这也是为什么每次发布更大模型,总会出现「惊喜」——那些能力在小模型阶段根本没有信号。
这和前面说的「非线性」是同一件事的不同层次:激活函数在神经元层引入非线性,让单个神经元能表达复杂判断;涌现是非线性在整个模型规模层面的体现,让能力随规模出现质变而非量变。
模型是怎么训练出来的?预训练是什么?
自监督学习:用海量文本,让模型不断预测「下一个词是什么」,预测错了就调整权重。
训练数据里有一句话:「今天天气很___」
模型猜:好 / 热 / 差
对比实际下一个词:好
错了 → 调整权重 → 再猜
不需要人工标注,文本本身就是答案。这叫自监督学习——数据提供了隐式反馈。
训练的完整循环:
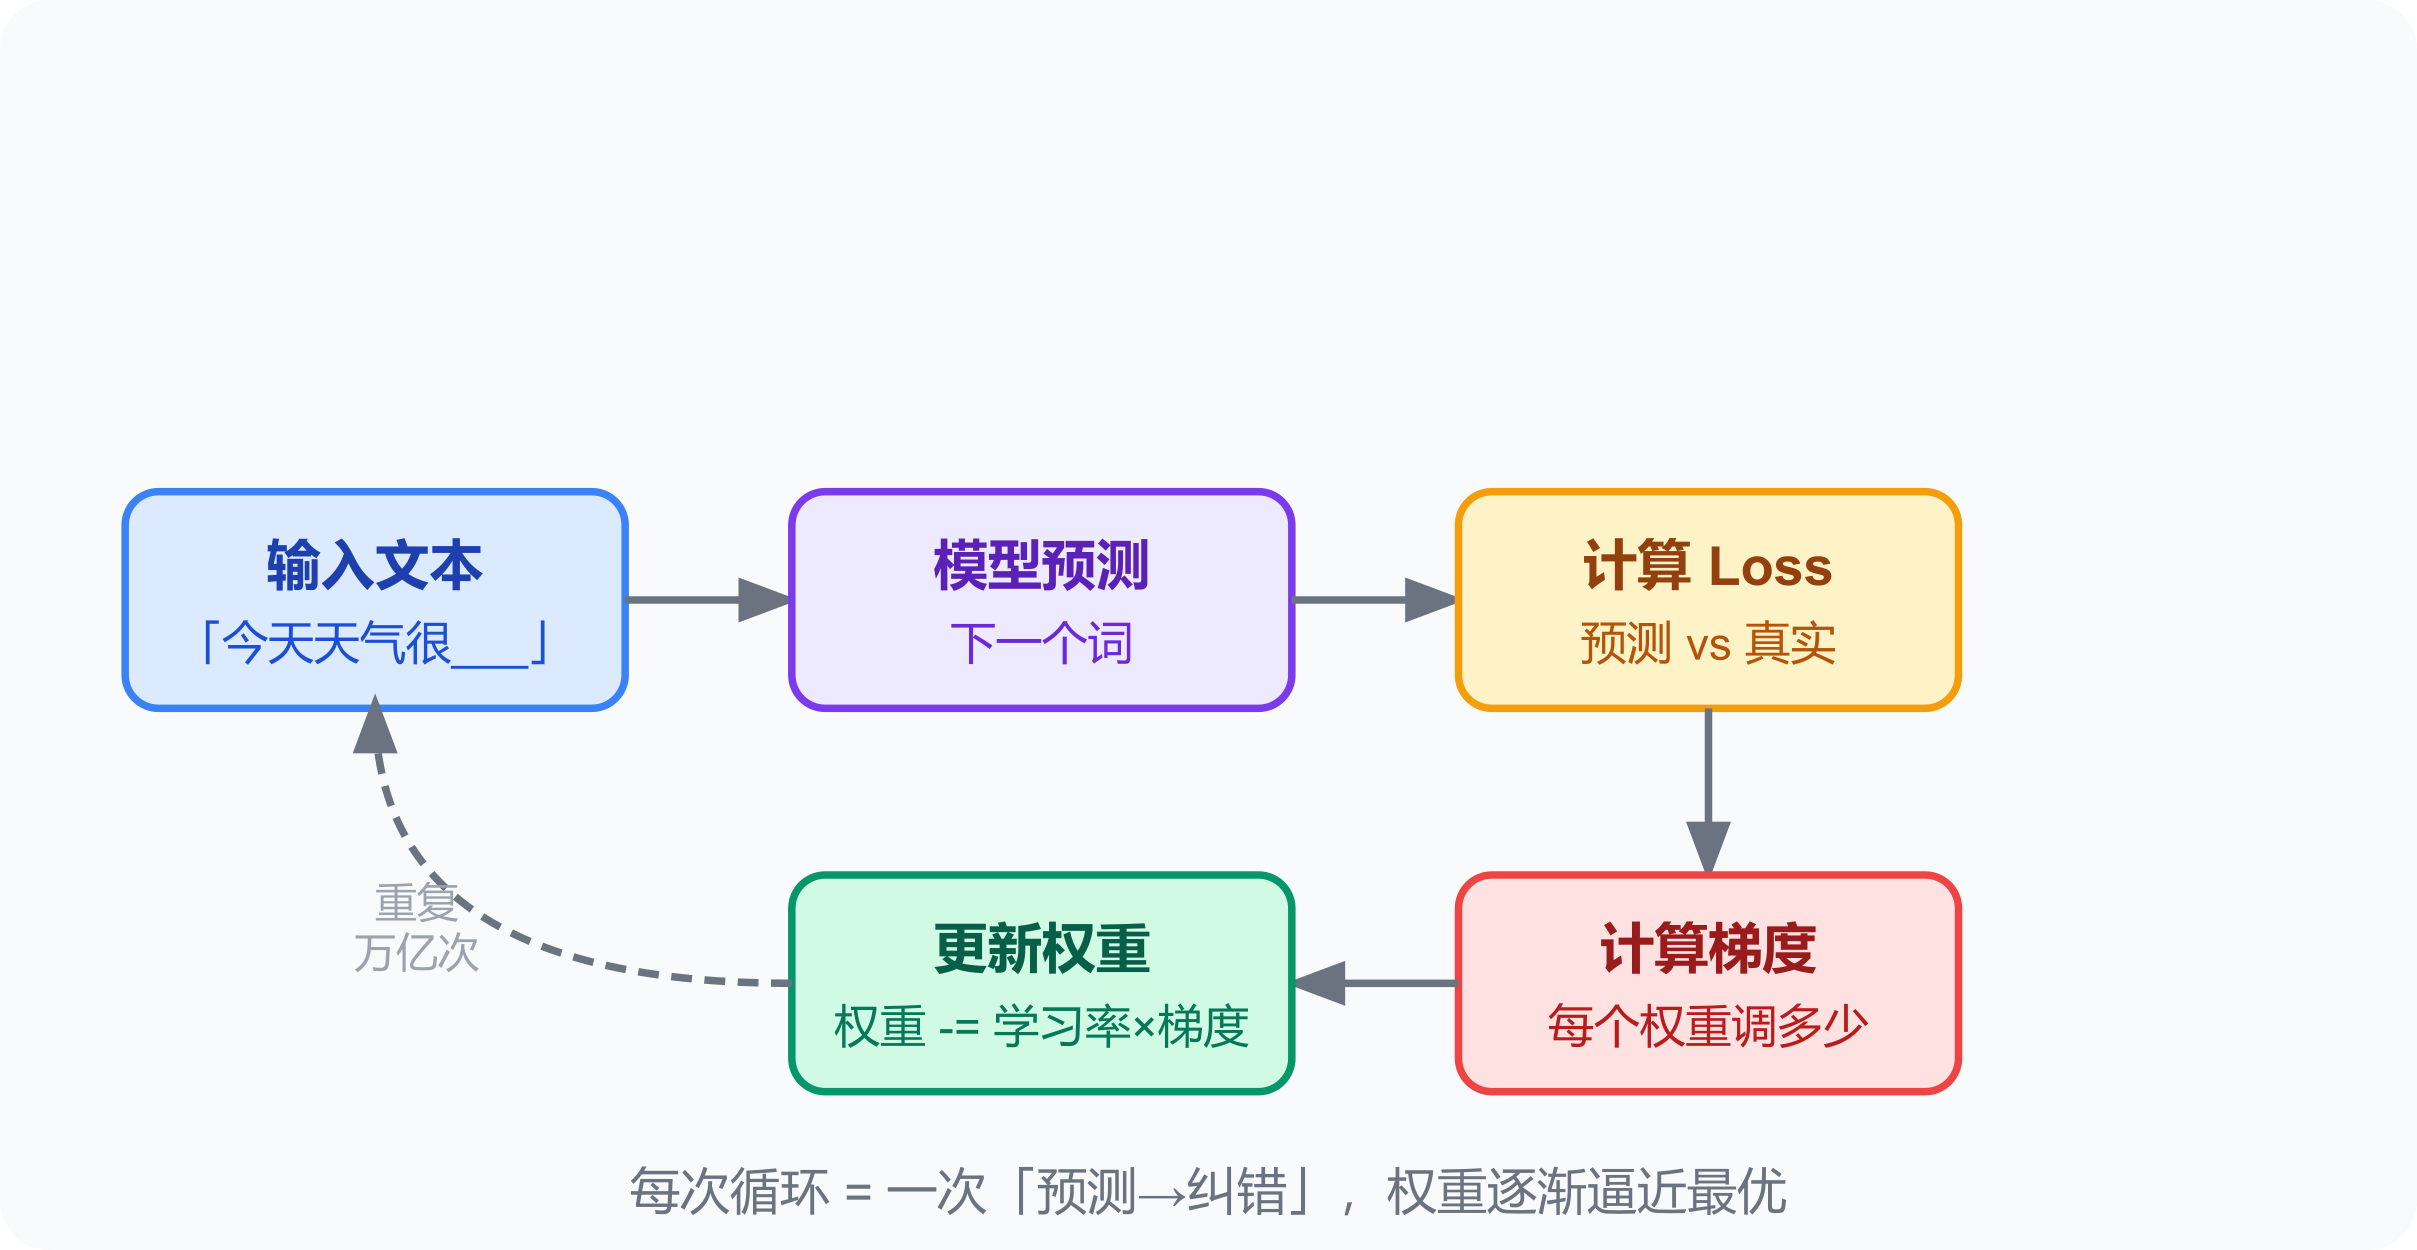
这个循环重复几万亿次,模型就「学会」了语言。
预训练:用几万亿个这样的填空,让模型学会语言规律。这是训练的主体阶段,消耗计算资源最多。
之后还有 RLHF(基于人类反馈的强化学习):人类对模型回答打分 → 训练奖励模型 → 让模型输出更符合人类偏好。这才是「有人打分评价」的阶段。
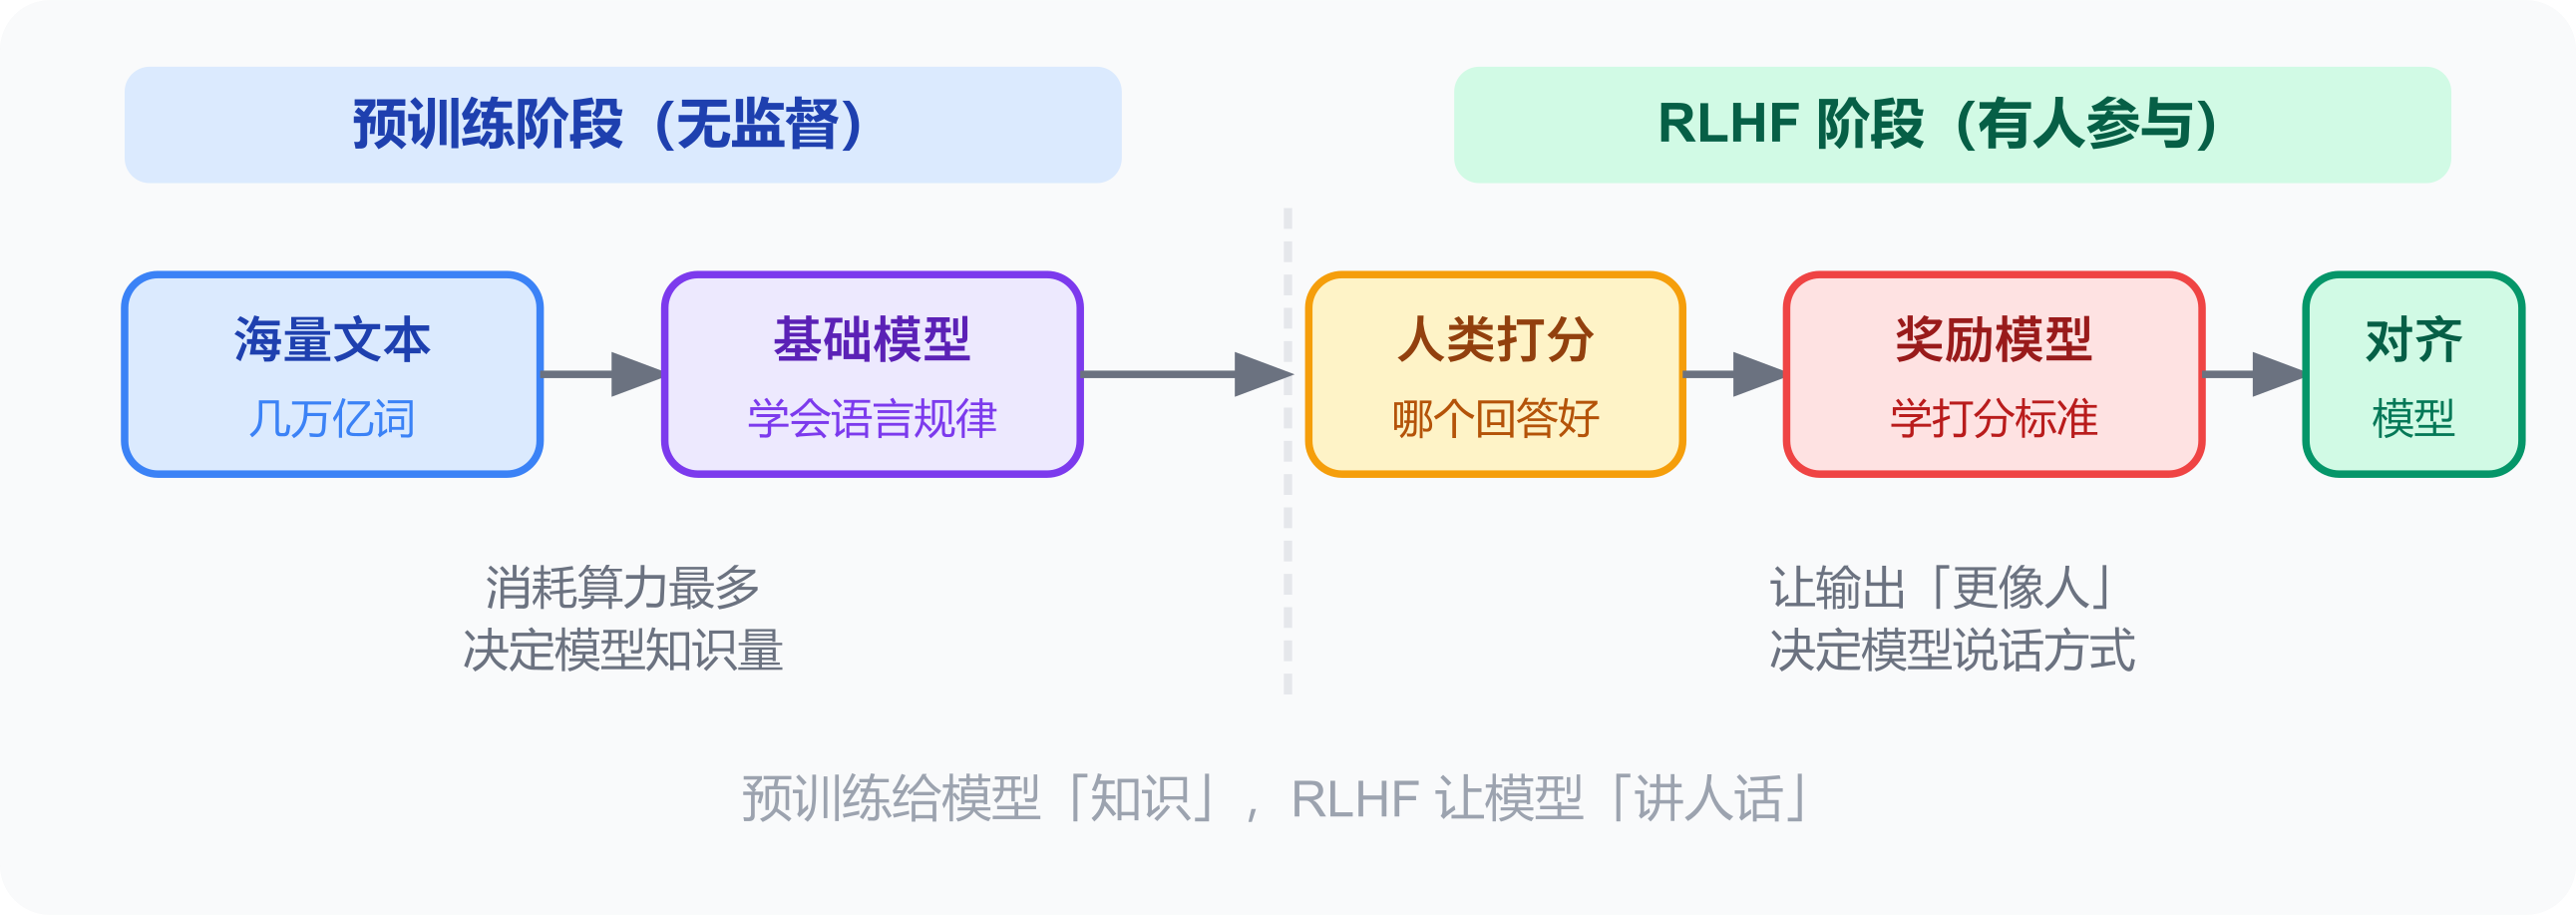
梯度是什么?谁给反馈?
梯度 = 每个权重「往哪个方向调、调多少」的指令。
可以用「下山」来直觉理解:
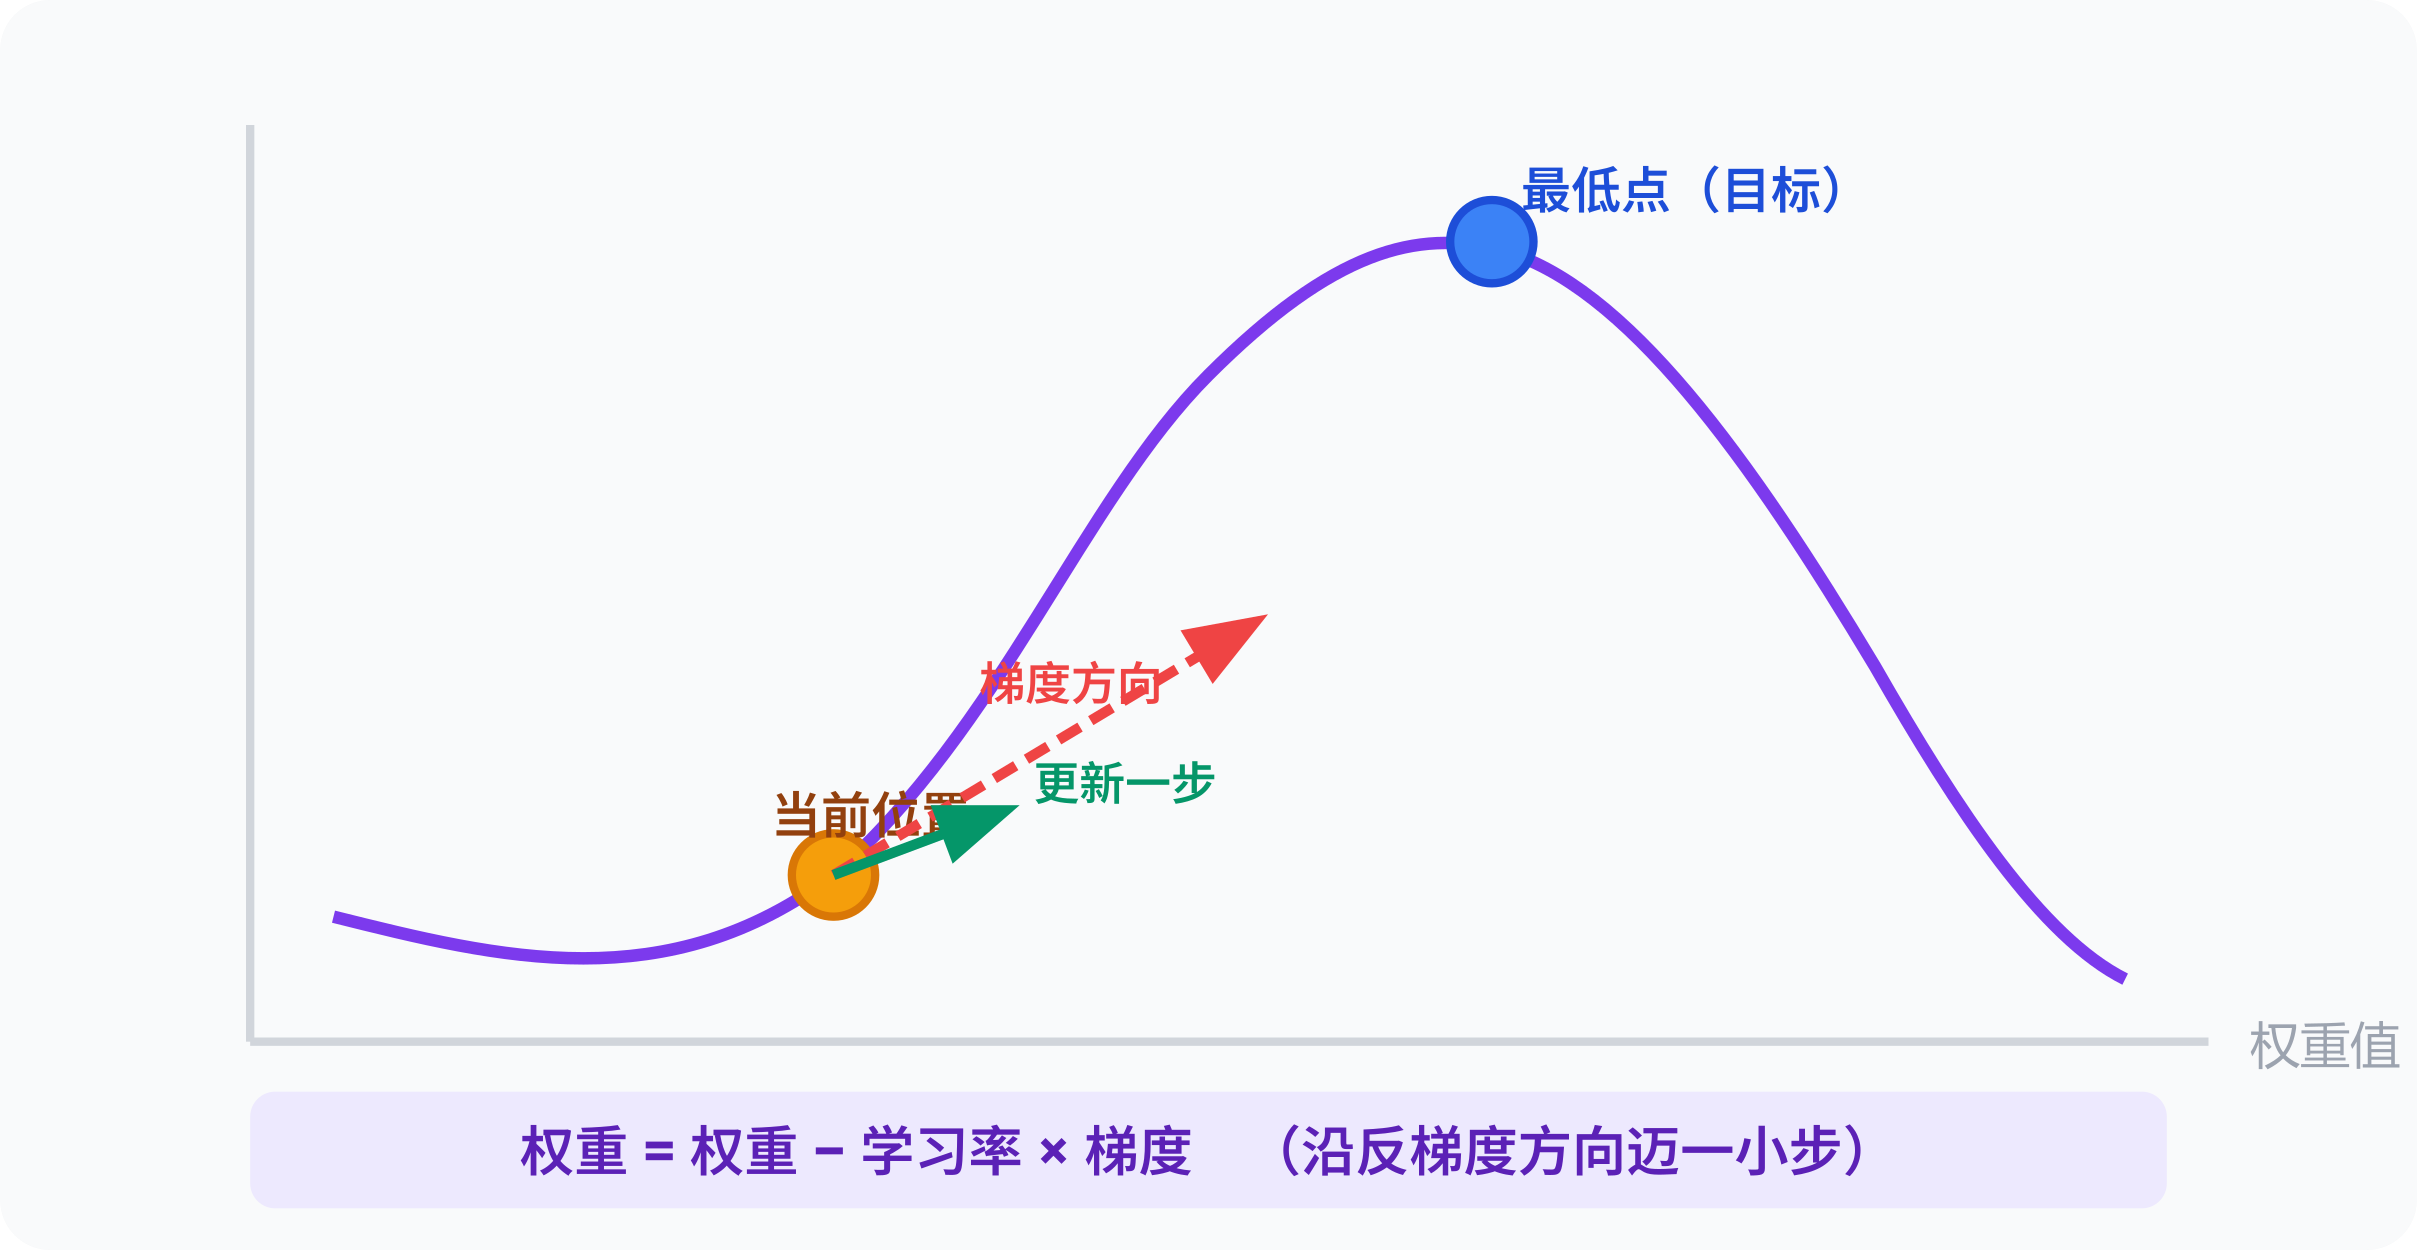
预测错了 → 计算 loss(错误程度)
对每个权重求偏导:「这个权重 +0.01,loss 变多少?」
这个导数 = 梯度

更新:权重 = 权重 - 学习率 × 梯度
梯度为负(权重增加则 loss 减少)→ 权重增加
梯度为正(权重增加则 loss 增加)→ 权重减少
谁给反馈:训练数据本身。预测「下一个词」,答案就在文本里,不需要人工标注。数据 = 隐式反馈源。RLHF 阶段才有人类显式打分。
训练不会等「loss 完全不减少」才停,而是固定跑多少步,或验证集 loss 开始上升就停(防止过拟合)。
什么是过拟合?「拟合」怎么理解?
拟合 = 让模型输出贴合数据。
过拟合 = 贴得太紧,把训练数据里的噪音和特例也学进去了 → 记住了答案,没有学到规律 → 遇到新数据失灵。
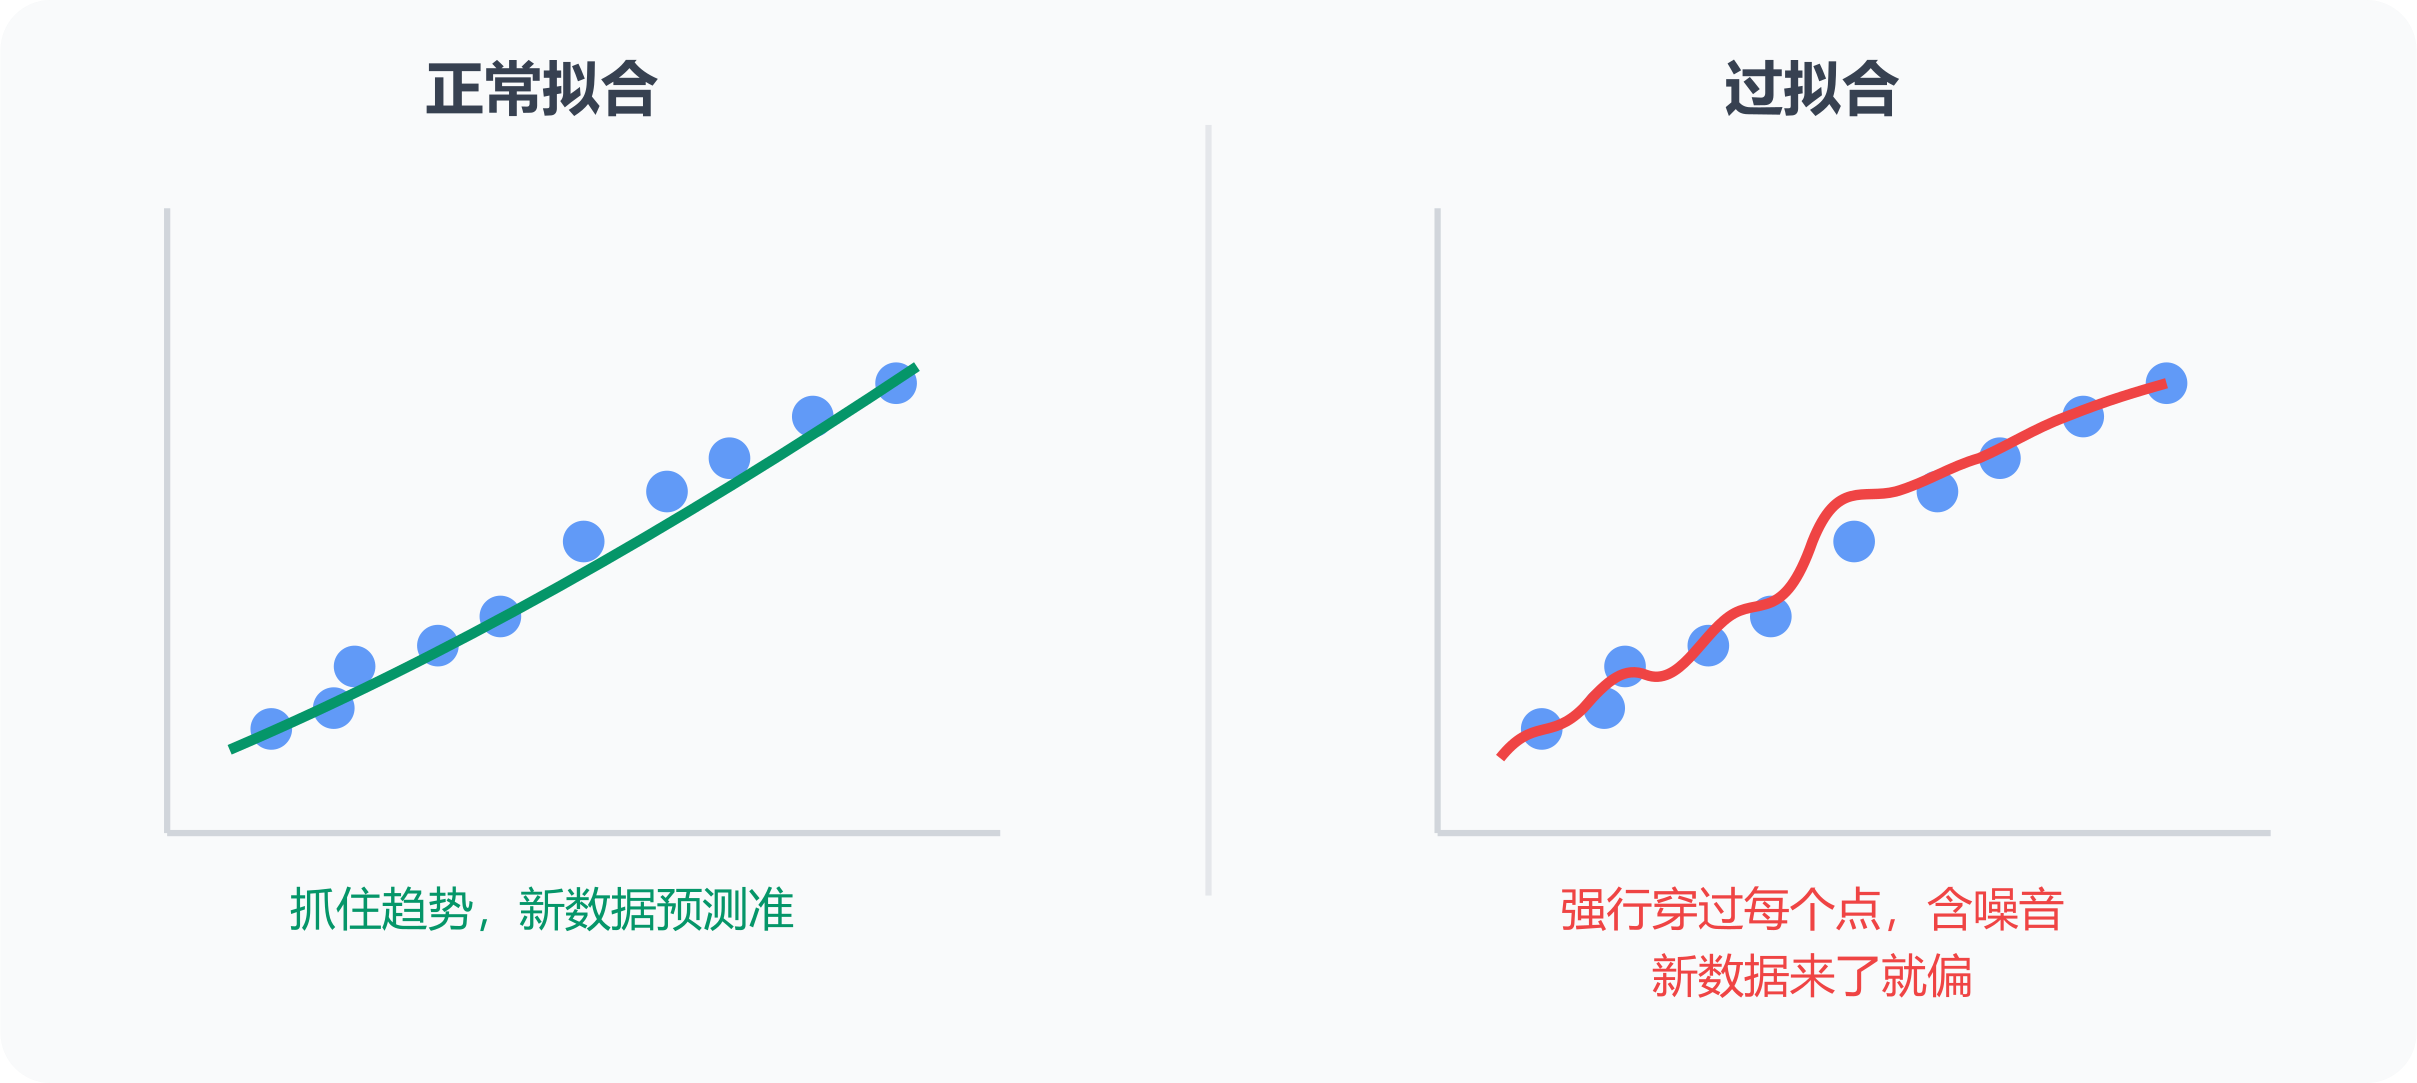
类比:学生死记硬背历年考题的答案,每道题都能背出来(训练 loss 极低),但换一道新题就不会了(验证 loss 很高)。
如何检测:
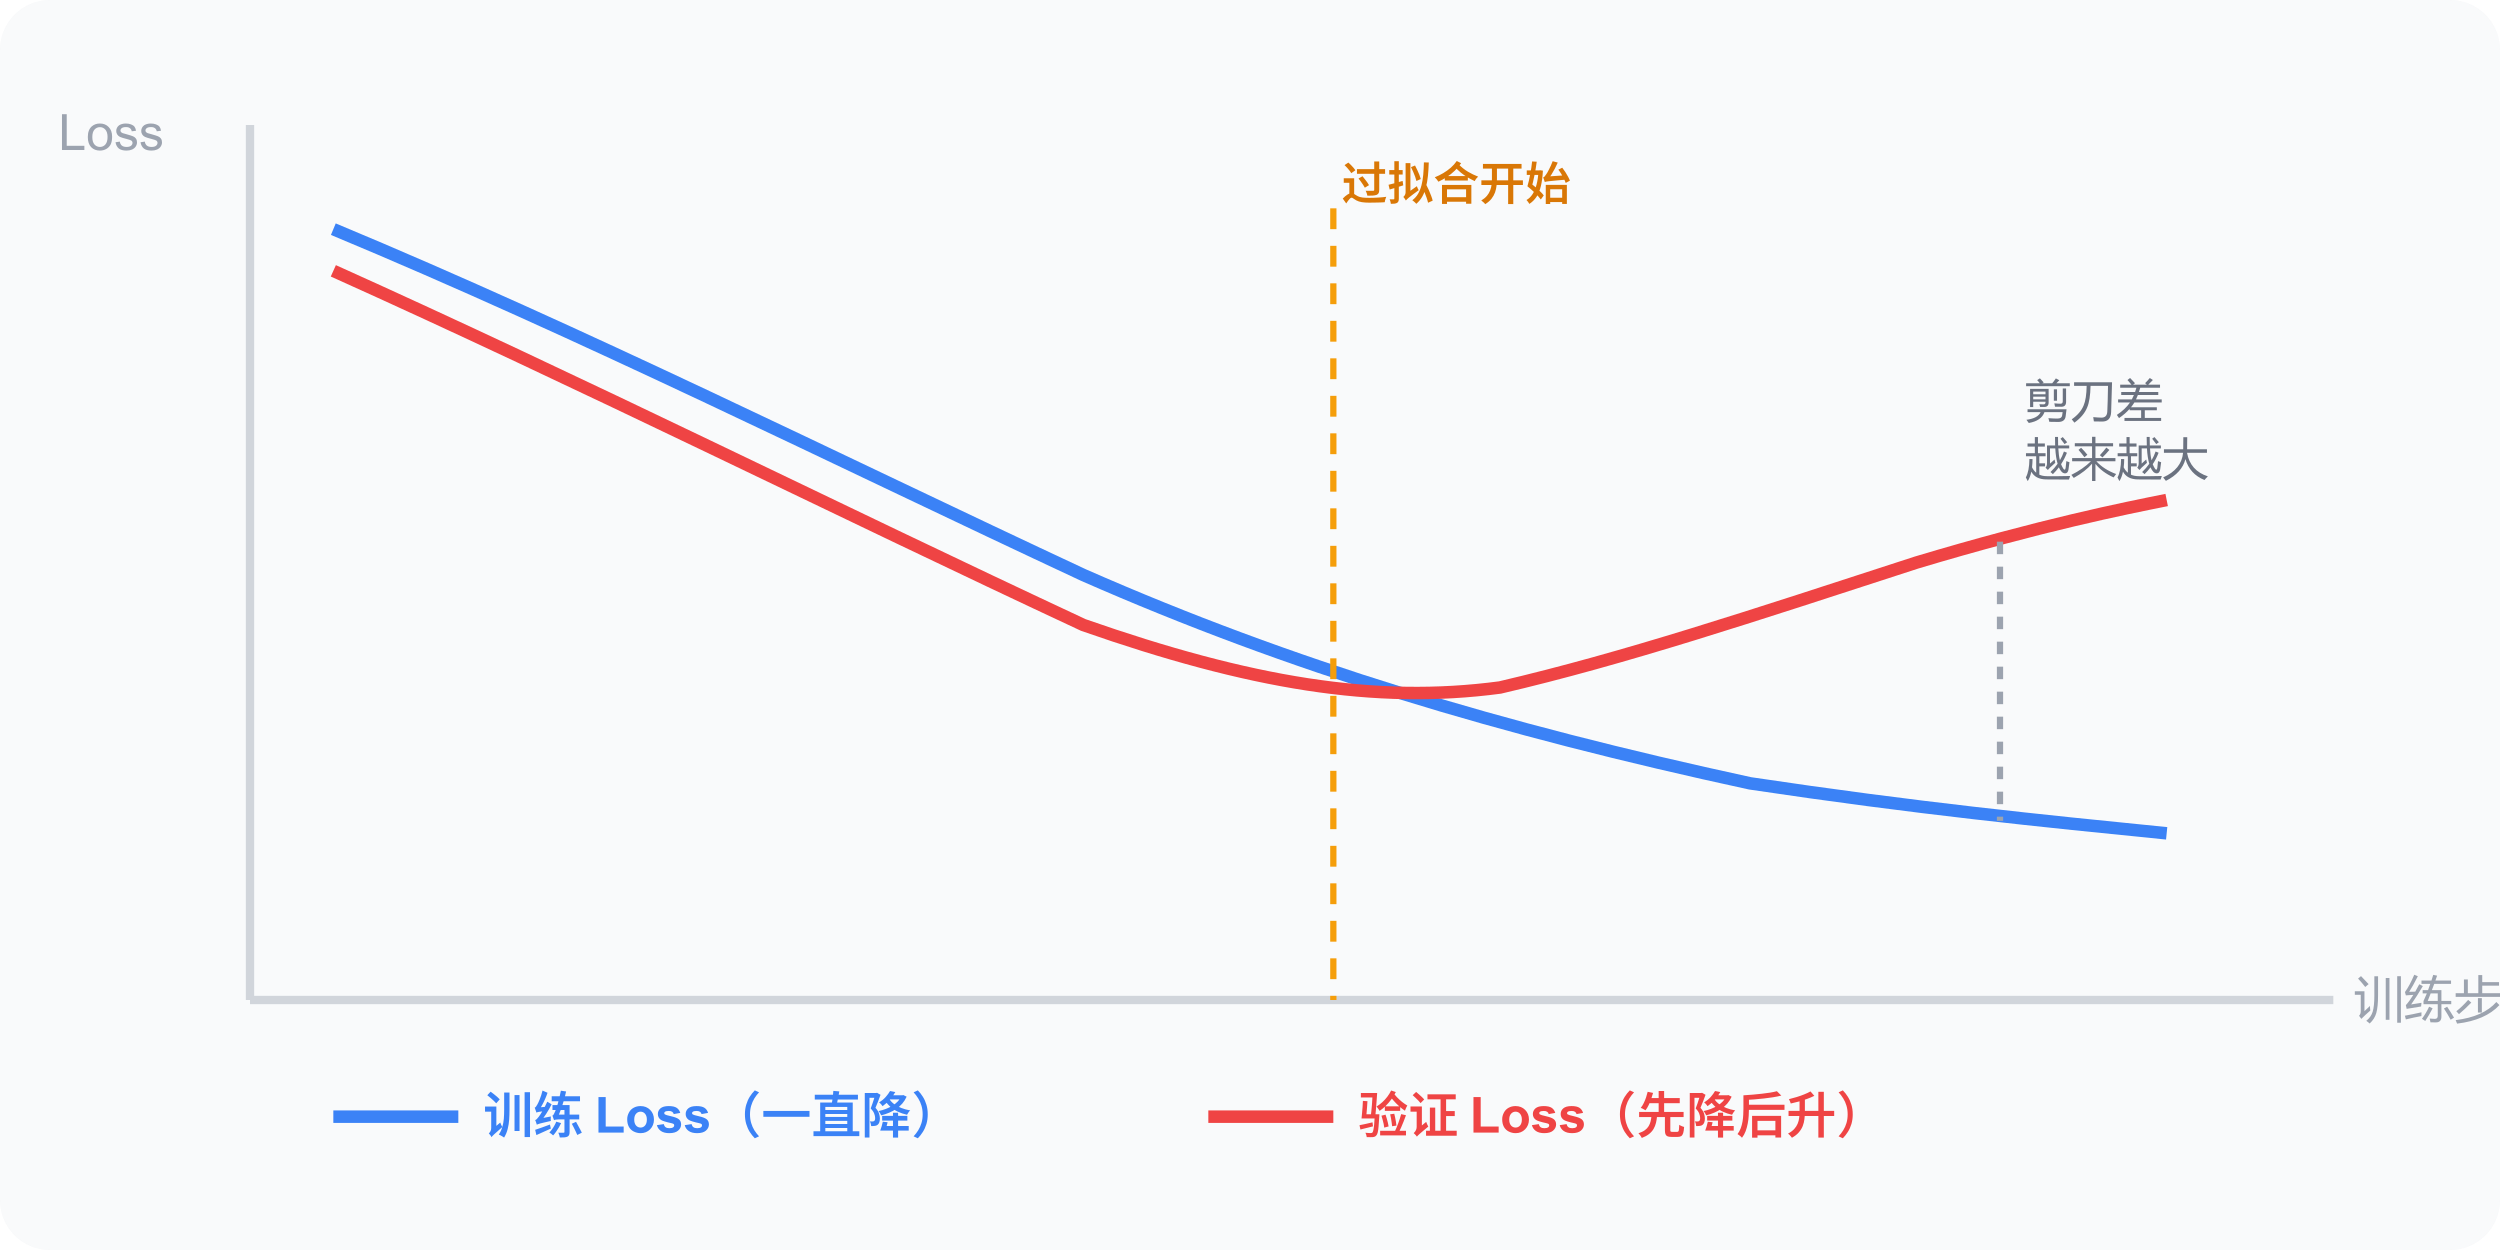
信号:训练 loss 持续降低,验证 loss 开始上升 → 剪刀差出现 → 过拟合了。过拟合是模型在训练集和新数据上表现出现分离。
小结:涌现与训练
这部分讲的是训练的完整过程——从涌现现象说起,到预训练的机制和梯度的直觉,再到过拟合的识别。把这些放在一起,是因为它们都在回答同一个问题:模型怎么从什么都不会,变成什么都能说?
- 自监督预训练:预测下一个词,文本本身就是答案,不需要人工标注;预训练消耗最多计算资源
- 梯度 = 调权重的指令:告诉每个权重往哪个方向调、调多少;用「下山找最低点」来直觉理解
- 过拟合 = 记住答案而非学到规律:训练 loss 低,验证 loss 高,剪刀差出现就是信号
理解了训练过程,才能理解为什么大模型「会说话」但不等于「知道事实」——这正是接下来要讲的核心问题。
幻觉是什么?为什么会发生?
幻觉 = 模型生成了听起来合理但事实错误的内容。
根本原因:模型不是在查数据库,是在预测下一个最可能的 token。
幻觉的产生机制:
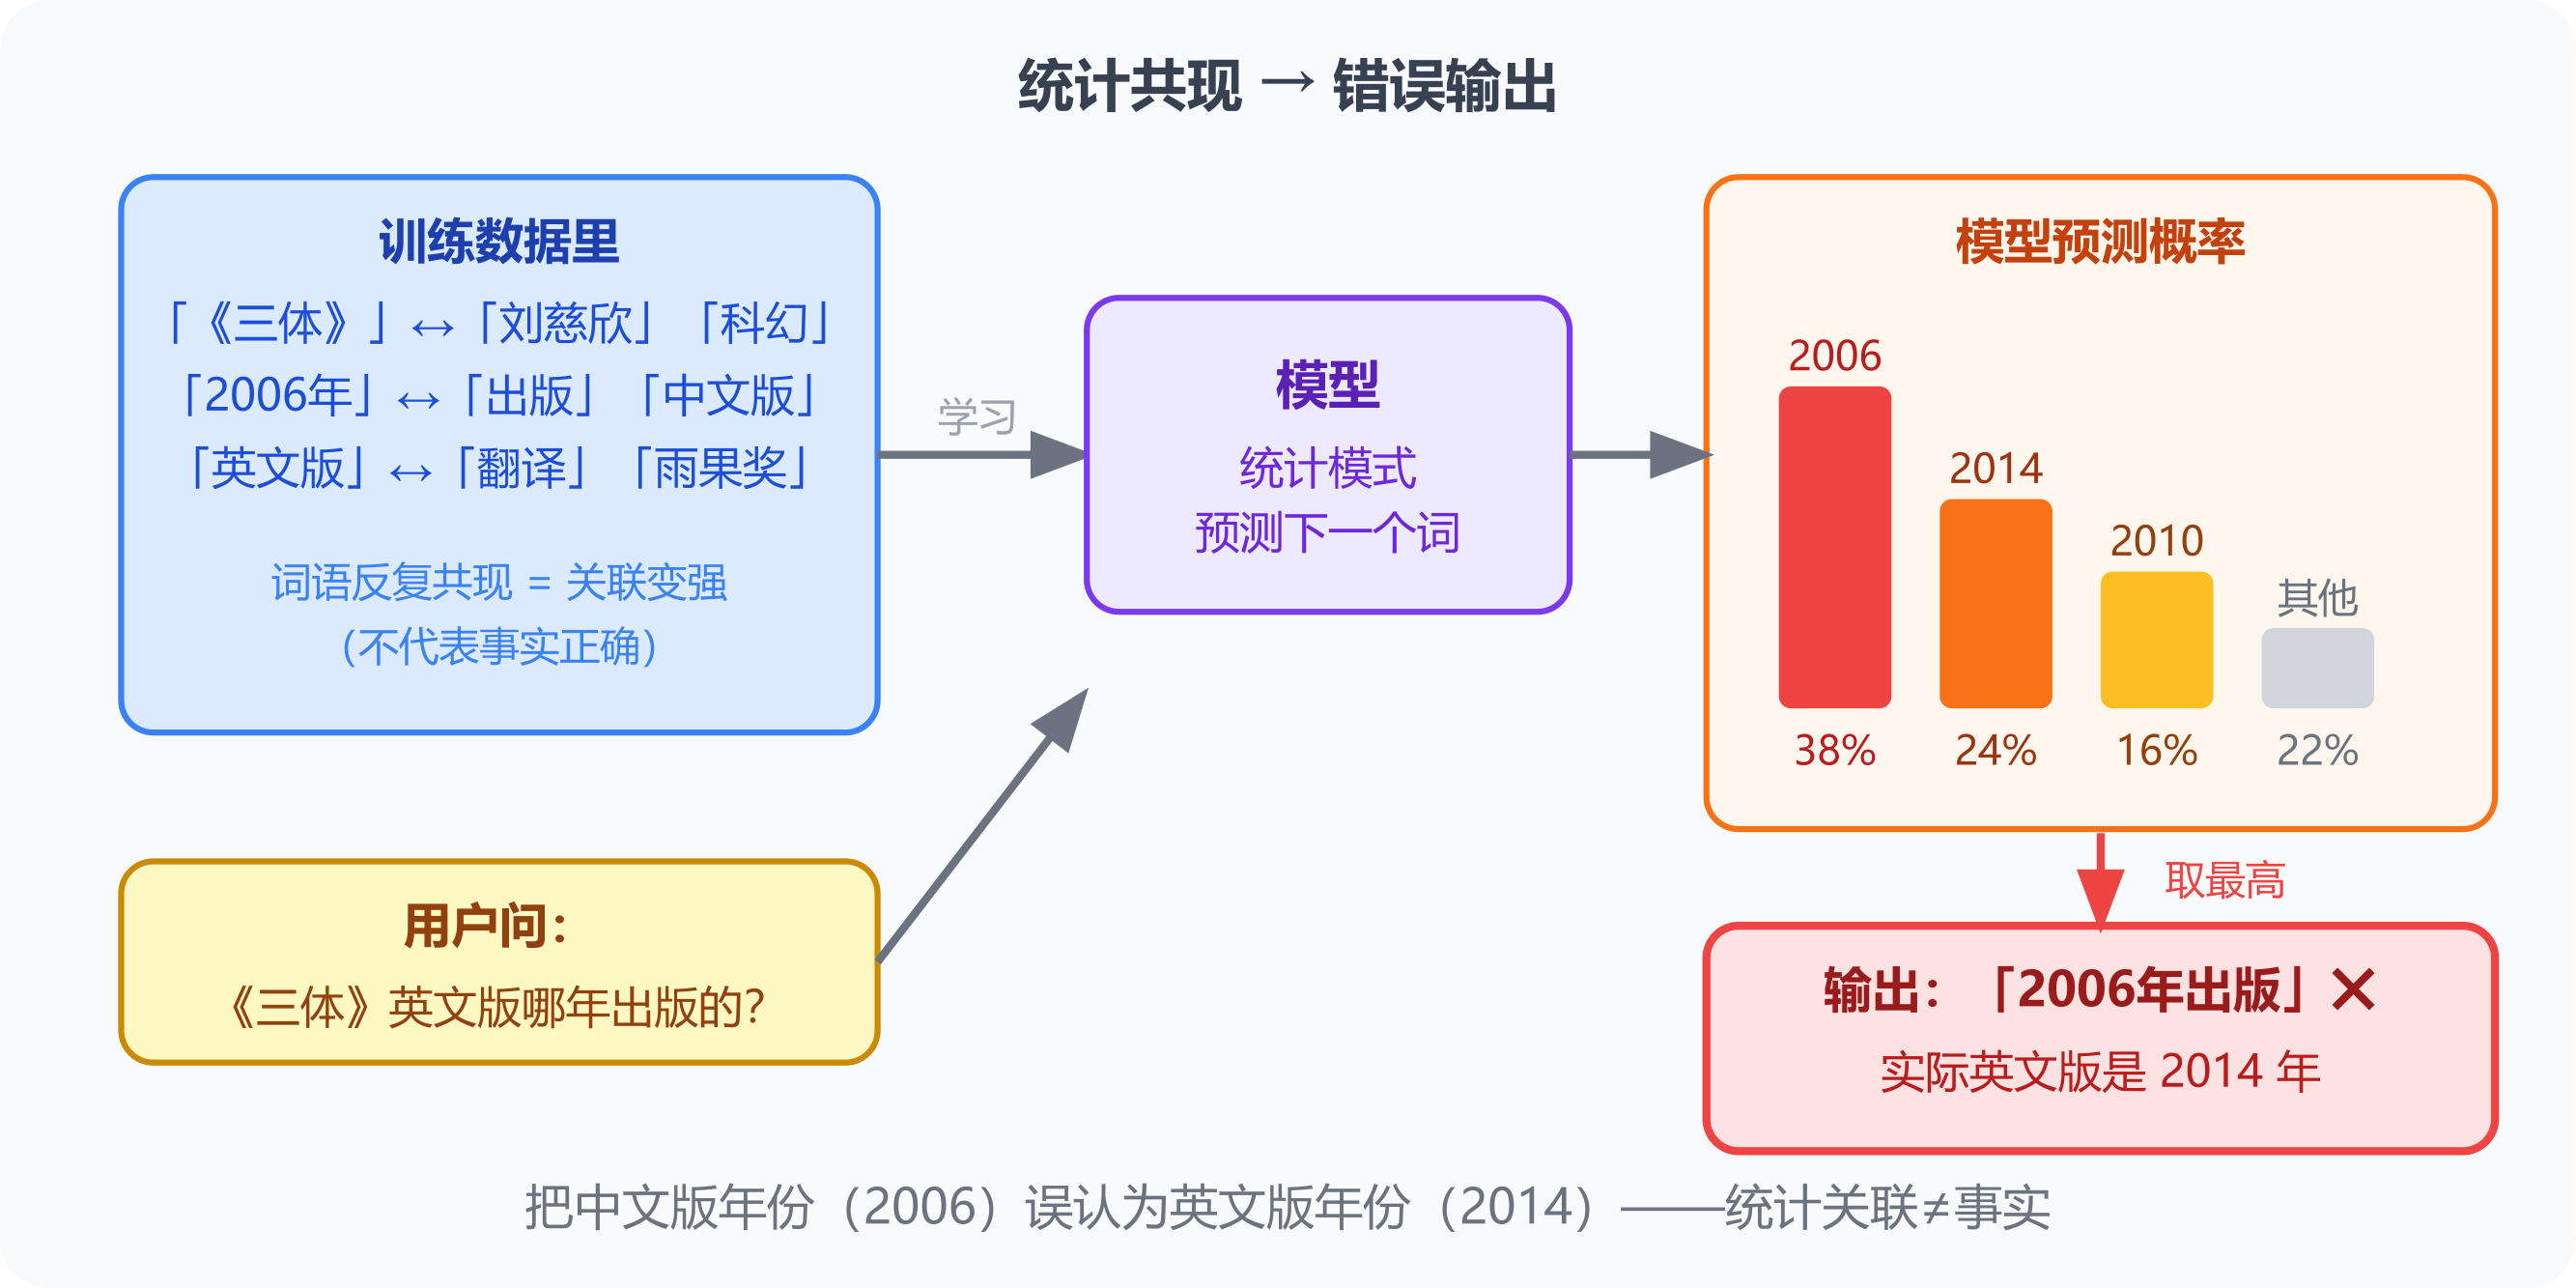
它不是在说谎,也不是查错了数据库——它根本没有查。纯粹是统计模式匹配产生了错误组合。
类比:人类也有「概念混淆」——两个概念经常一起出现,就产生「它们有因果关系」的错觉。幻觉是同一个机制在模型里的体现。
幻觉是能力的代价,不是 bug。想要 100% 确定的答案,用数据库查询,不用生成模型。
好发于:具体数字、版本号、规格、冷门事实。技术规格类问题,永远要验证。
幻觉有没有好的解决方案?
| 方法 | 效果 | 代价 |
|---|---|---|
| RAG(检索增强,给模型实时参考) | 高 | 需要搭检索系统 |
| 提高推理深度(低 / 中 / 高) | 中(更仔细但仍会错) | 贵 |
| 明确要求「不确定就说不知道」 | 中 | 在给 AI 的指令里加上即可 |
| 多次采样取多数 | 中 | 慢且贵 |
| 人工/程序验证 | 最可靠 | 需要额外工作 |
RAG 是什么原理:
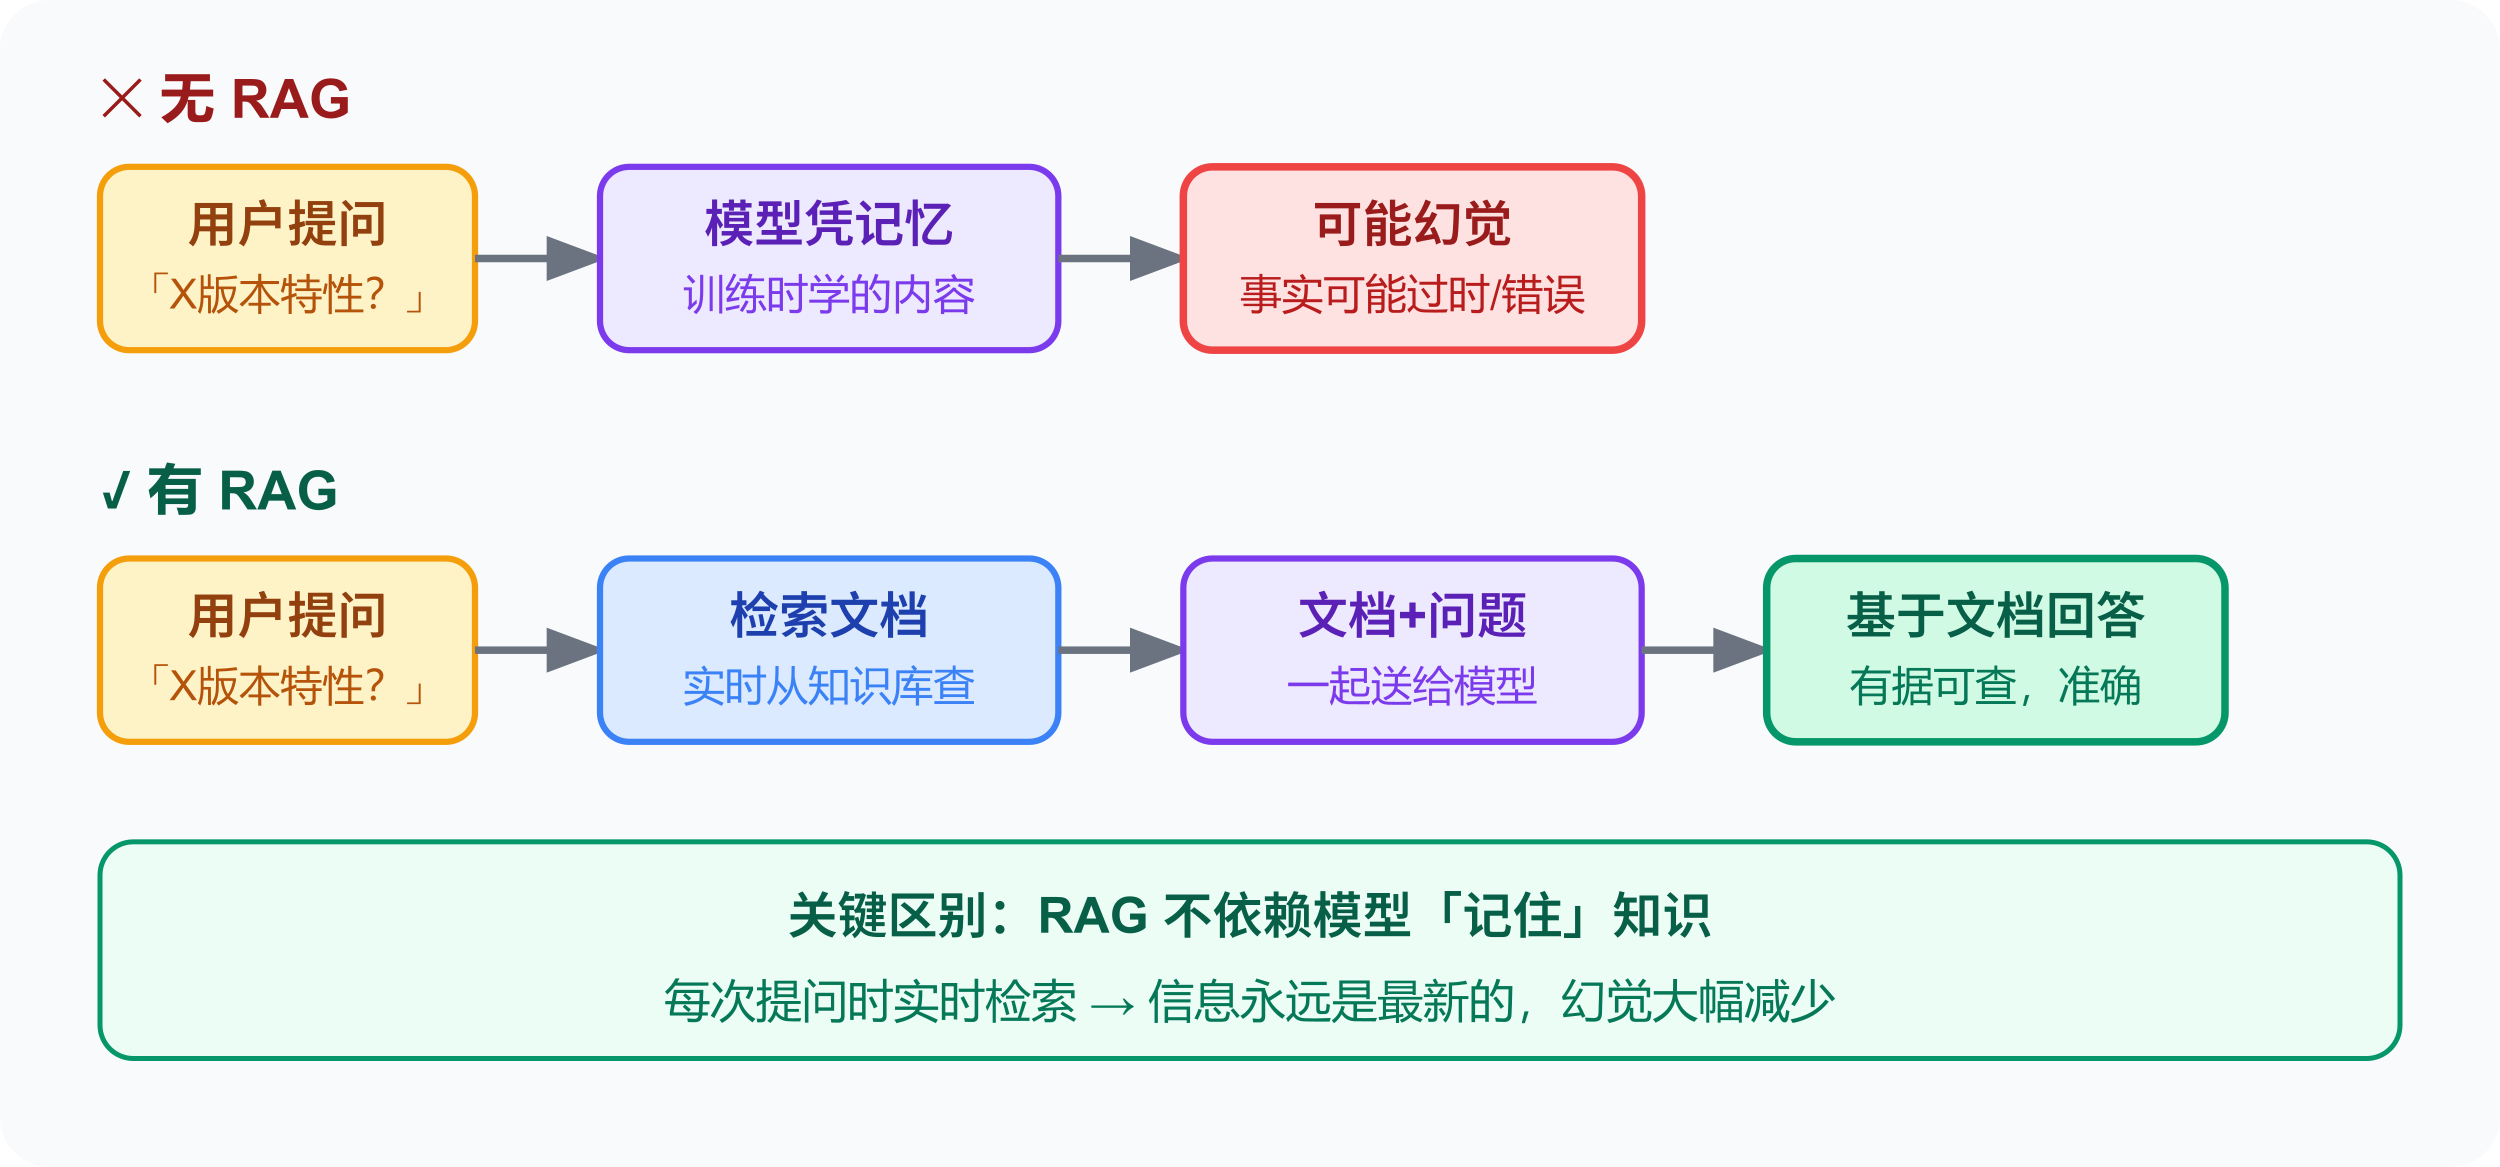
让 AI 主动说不确定,可以在对话开头加一句:「对于具体事实——不确定就明确说『我不确定,建议验证』。」
神经网络、深度学习、大模型——谁是谁的基础?
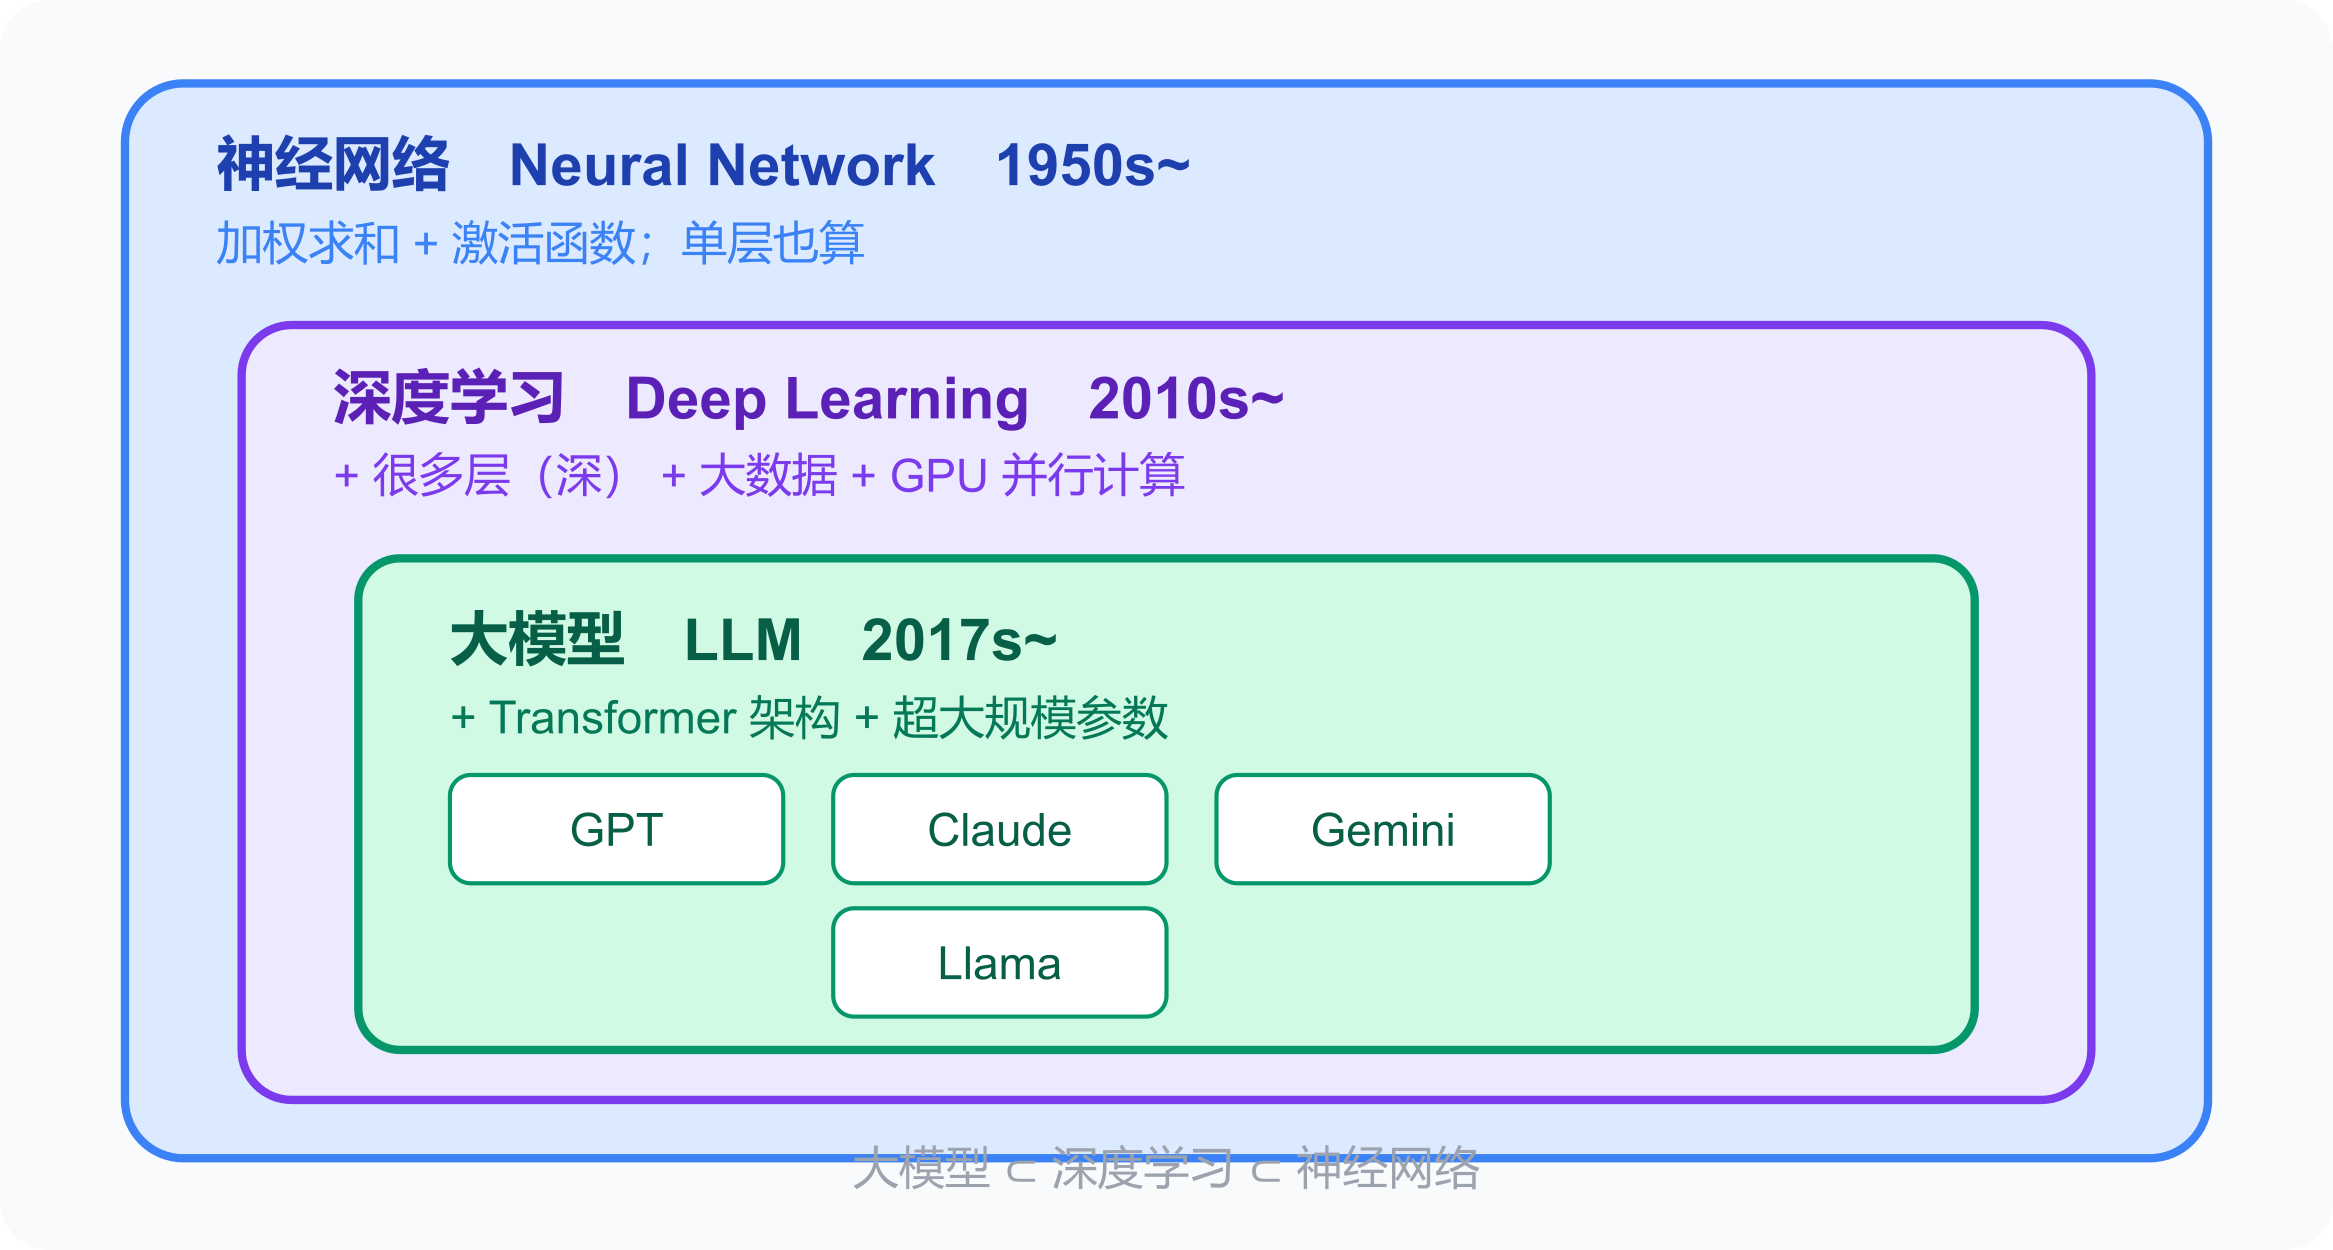
- 神经网络:基础概念,单层也算
- 深度学习:神经网络变深(很多层),突破了早期瓶颈
- 大模型:深度学习的超规模应用,加了 Transformer 架构
大模型是深度学习的子集,深度学习是神经网络的子集。
小结:幻觉
幻觉它不是偶发故障,而是「预测下一个词」这个机制的必然产物——能力和风险来自同一个根源。
- 幻觉的根本原因:模型在做统计模式匹配,不是在查数据库。「《三体》英文版出版年份」这类错误来自训练数据里的词语共现,不是在说谎
- 好发场景:具体数字、版本号、规格、冷门事实。这类问题永远要验证
- 最有效的应对:RAG 给模型实时参考资料;或在提示词里明确要求「不确定就说不确定」
全文串起来是一条完整的认知链:神经元 → 训练 → 幻觉。知道它是怎么建起来的,才知道它会在哪里出问题,才能更有效地使用它。
延伸思考
简单单元,复杂行为
神经网络的反直觉之处在于:每个最小单元极其简单,只会做加法和乘法;但几十亿个这样的单元叠在一起,配上足够多的数据,就能涌现出读懂语言、理解意图的能力。这不是设计出来的,是学出来的。
类似蚁群:单只蚂蚁没有智能,但整个蚁群能解决复杂问题。大模型的「聪明」不在任何一个神经元里,而在亿万个连接的整体涌现中。
权重就是反应
如果要找一个最贴近「大模型学了什么」的比喻,权重是最准确的答案。它不是存了哪些知识,而是形成了一套反应模式——遇到这种输入,倾向于产生那种输出。就像一个人经历了很多事情之后,形成了自己的直觉和判断方式。这些判断不是规则,是习惯。
学习就是不断犯错
大模型的训练,本质上就是反复试错。猜一个词,对比实际答案,算出错了多少,微调权重——这个循环重复了几万亿次。没有老师,没有规则,只有数据和反馈。人类学语言也是这样:听到的语言不断修正对「什么是正确表达」的感知,不需要先背语法规则。
量变与质变
涌现让很多人困惑:为什么把模型做大,能力会突然跳升?这不是「越来越好」的线性过程,更像水结冰——温度一直在降,但冰在某一刻突然出现。大模型也是这样:参数在积累,表面上看不出变化,但当某个任务所需的所有子能力都到位,能力就集中爆发。这也是为什么小模型的表现无法预测大模型——它们不是同一量级的延伸,而是不同的相态。
概率
大模型真正不同的地方,是它不是按固定规则返回确定结果,而是基于概率分布生成答案。传统系统追求稳定:相同输入,基本得到相同输出;但大模型的价值,恰恰来自这种受控的不确定性。它能在概率空间里组合、变化、探索,因此才有创造性和适应性。
这有点像生物进化:如果基因完全不变,系统一旦有致命缺陷,就没有容错空间;而变化带来了新的可能性。对大模型来说,概率不是缺陷,而是能力的来源。它真正的分水岭,不是"更大的数据库",而是从确定性规则走向概率化生成。
大模型约等于人
训练大模型的过程,可以类比人的成长过程。模型架构,就像人先天的神经结构和基础能力;而输入的数据,则像人后天所处的环境、教育和经历。即使先天条件相似,只要接受的信息不同,内部形成的反应方式和判断倾向(权重)也会不同。
所以看大模型时,可以尽量从"人的成长"这个角度去理解:它不是简单地存储知识,而是在特定架构下,被大量数据塑造出一套反应模式和认知方式。大模型的训练,本质上就是一个系统被环境长期塑造的过程。